头顶飞过的飞机,能暴露你在哪里开会
🌐 语言:中文 · English
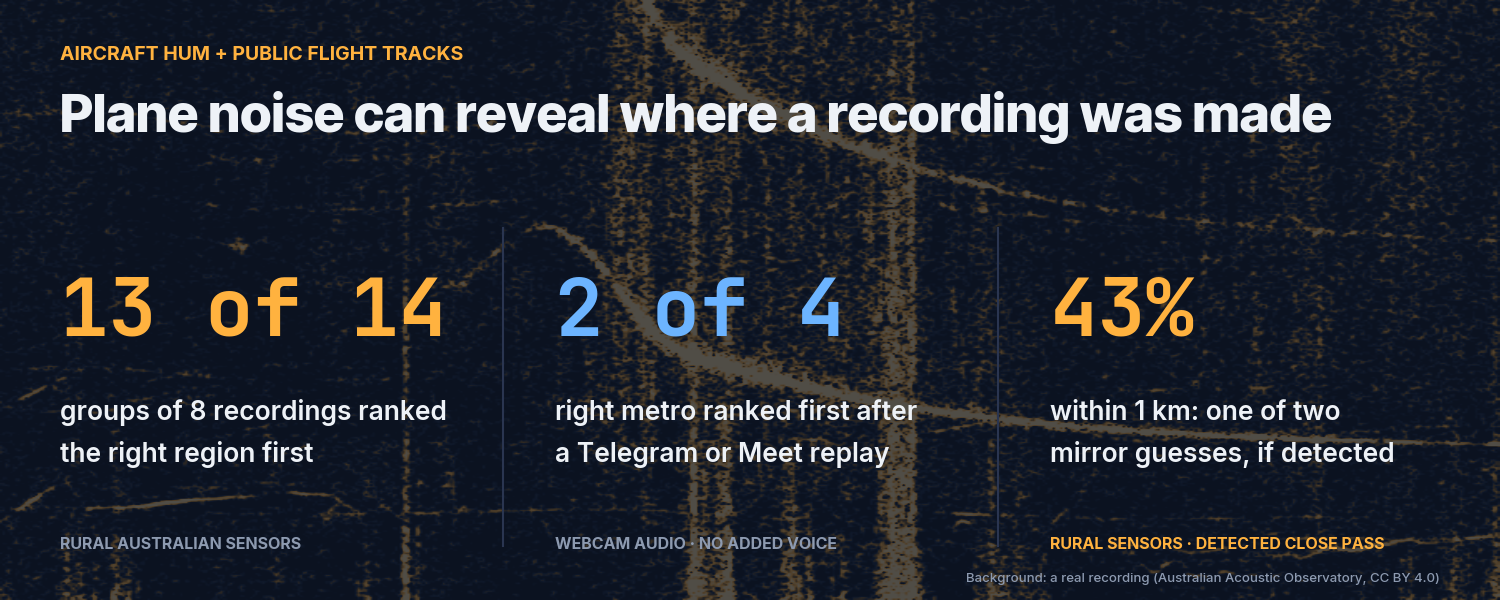 封面:“飞机噪声能暴露录音的地点”,背景是一张真实的频谱图,图中是一架飞机不断滑动的嗡鸣(Australian Acoustic Observatory,CC BY 4.0),并列出三项主要结果。
我在 San Carlos 和尔湾的时候,总能听到小飞机从头顶飞过。它们大多会广播自己的位置,公开的飞行记录会把这些位置保存下来,时间戳精确到秒。于是我就想:如果有人录音的时候正好有飞机飞过,飞机的噪声能不能暴露录音的地点?
能。
- 澳大利亚乡村同一地点的八段一小时录音为一组:14 组中有 13 组把正确区域排在第一,来自 8 个站点。
- 检测到一次近距离飞越,且已知所在的局部范围:75 次飞越中,两个镜像猜测点之一落在 1 km 以内的占 43%。
- 把户外摄像头的音频经 Telegram 和 Google Meet 重放,不叠加人声:每个应用上都是 4 个站点中有 2 个把正确的都会区排在第一。这个样本非常小。
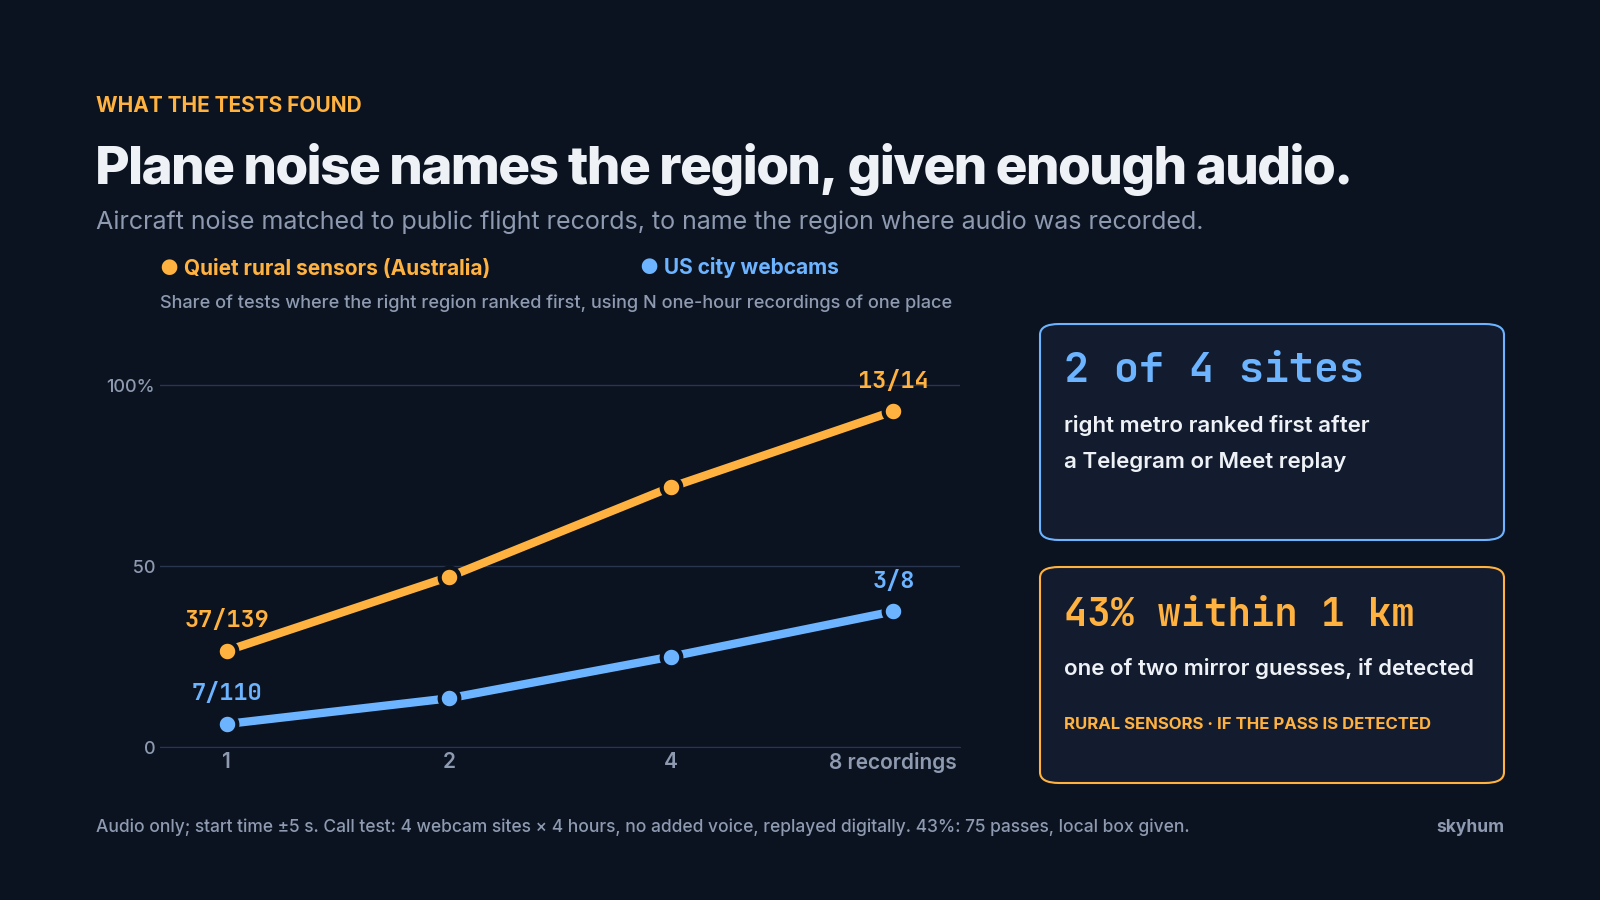 主要结果。根据飞机噪声和公开飞行记录说出正确区域,澳大利亚乡村传感器:1 段一小时录音时为 37/139,同一地点 8 段录音为一组时升到 13/14;美国城市摄像头从 7/110 升到 3/8。经 Telegram 和 Google Meet 传输且不叠加人声时,4 个站点中有 2 个把正确的都会区排在第一。一次近距离飞越,前提是我们的响声事件检测器能捕捉到:75 次飞越中,最佳猜测在 1 km 以内的占 43%(2 km 以内占 63%),以检测到为条件。
分组的区域排名重放实验只覆盖了这四个摄像头站点。在最大的两个录音系列(澳大利亚乡村传感器和美国摄像头)中,如果我们有同一地点的多段一小时录音,正确区域排在第一的比例就更高。
开源。skyhum 工具、训练好的检测器以及复现这些数字的代码都已开源,地址是 https://github.com/bojieli/skyhum (alpha),公开摄像头各小时的派生特征(不含音频)放在 v0.2.0-alpha release 中。它用于研究和防御,不是用来定位普通个人的。基准测试的元数据只有链接,从不包含音频。
远处的嗡鸣提示区域;近距离飞越可以进一步缩小范围
这两条线索的尺度不同。远处的嗡鸣能把搜索范围缩小到一个区域(美国的一个都会区或县,或澳大利亚的一个 SA4),只凭一小时的话效果很弱。近距离飞越(飞机在大约 1.5 km 以内)能把麦克风定位到一两公里之内,前提是我们的响声事件检测器捕捉到了它,并且搜索时已经有了一个局部范围。这一点我们只在澳大利亚乡村传感器上测量过。
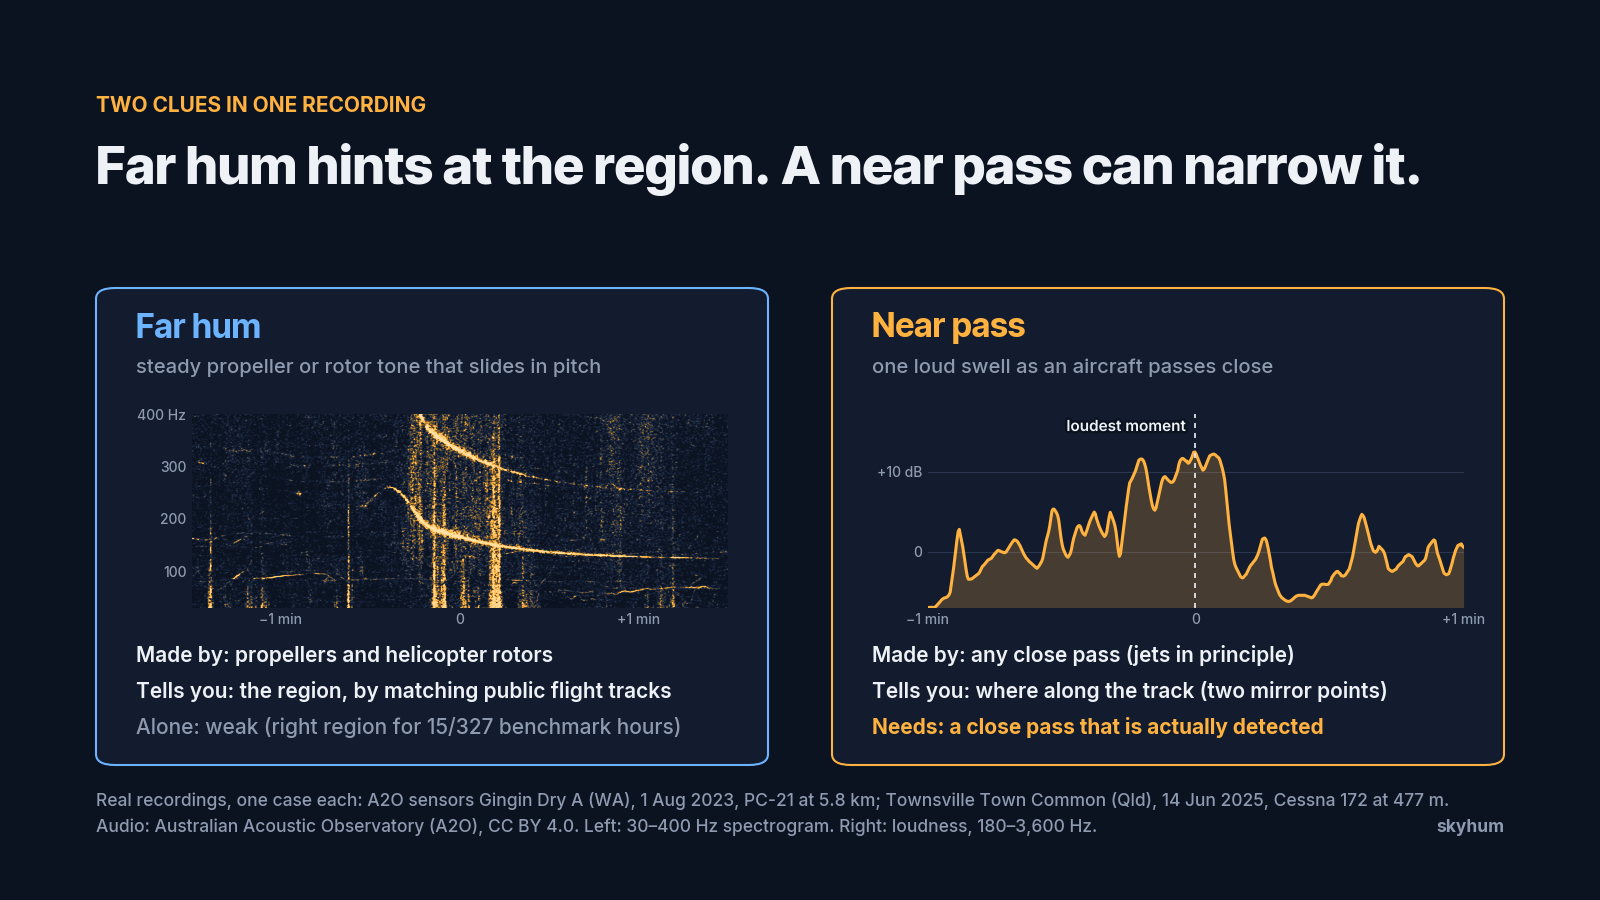 两个真实案例。远处的嗡鸣:一架 PC-21 教练机从距澳大利亚某传感器 5.8 km 处飞过的真实 30–400 Hz 频谱图,音高呈 S 形下滑;它通过匹配公开航迹帮助缩小区域,单独使用时很弱(基准测试中 15/327 小时区域正确)。近距离飞越:一架 Cessna 172 从 477 m 外飞过的真实响度曲线,在最响的时刻达到峰值;它告诉你麦克风在航迹方向上的位置,给出两个镜像点,并且需要一次确实被检测到的近距离飞越。
**远处的嗡鸣。**螺旋桨和直升机旋翼会发出稳定的音调。和驶过的警笛一样,飞机接近时音高略高,远离时略低。这段滑动的形状取决于飞机的速度、飞得多近,以及什么时候离得最近。飞机的位置是广播出来并公开存档的。如果有人知道录音的开始时间,误差在半分钟左右,就可以把音高曲线和当时的航班对比,看地面上哪些位置能对得上。远处嗡鸣的方法是 colsto 的,出自视频 I discovered a sound that leaks your exact location(2026 年 11 月 2 日)。colsto 没有公开代码。我们起步时用的独立开源实现 AlanBacker/audio-flyover-geolocation 只覆盖远处的嗡鸣,而且只在合成音频上测试过。**在真实录音上它并不准确。**在 8 个真实案例上,使用同样的本地搜索框和盲时钟窗口,它有一个没有给出答案,另一个没有跑完,给出的六个答案偏差在 3.6 到 45.9 km 之间。我们训练了一个检测器,构建了一个真实录音的基准测试,并重写了搜索。在同样的 8 个案例上,我们的最终版本有 7 个在 1 km 以内。
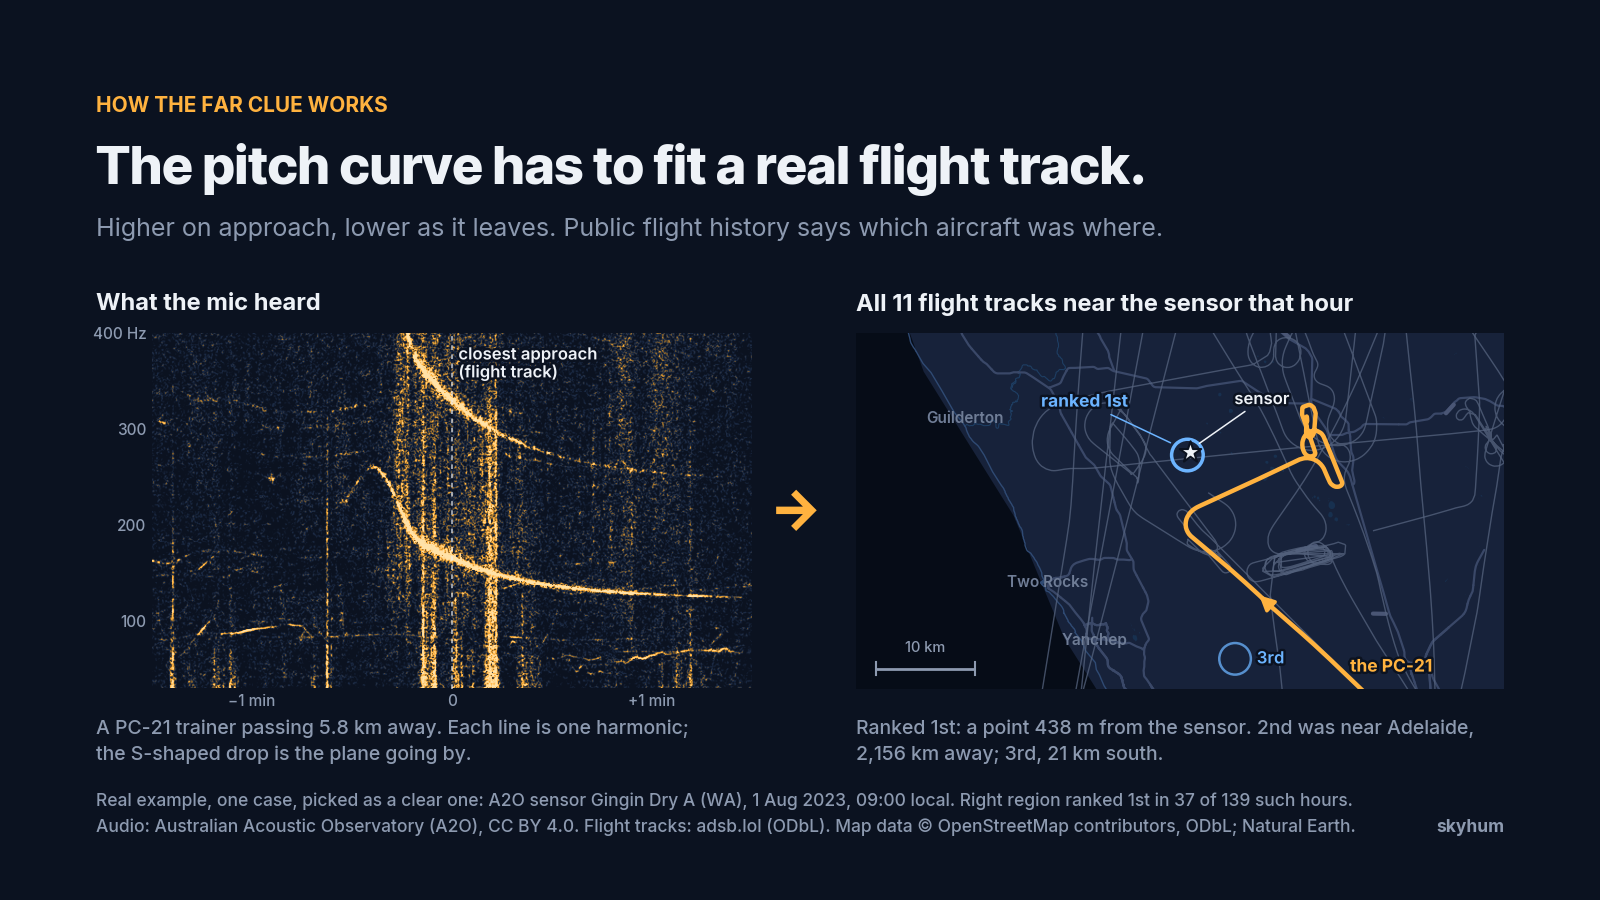 远处线索的原理,使用真实数据。左:澳大利亚某传感器(西澳 Gingin,2023 年 8 月 1 日)一小时录音的频谱图,其中有一架 PC-21 教练机从 5.8 km 外飞过时的 S 形下滑。右:地图上该小时内传感器附近的 11 条真实航迹,PC-21 高亮显示。正确区域排在第一,给出的点距传感器 438 m;排在第二的地点在阿德莱德附近,相距 2,156 km。
一架飞机很少能一锤定音。一小时内或者多段录音里的几架飞机加在一起,才能把答案缩小到一个区域。
**近距离飞越。**近距离飞越会产生一阵宽带的声浪(原则上喷气机也算;我们的定位测试主要是螺旋桨飞机的飞越)。最响的时刻接近飞机离得最近的时刻。飞机在那一秒处于航迹上的位置,就给出了麦克风在航迹方向上的位置。光靠声音分不出麦克风在航迹的左侧还是右侧,于是麦克风有两个可能的位置,互为镜像。它在航迹方向上的定位比一条嗡鸣曲线更紧,但要拿到它难得多,原因见后面讲近距离飞越的一节。
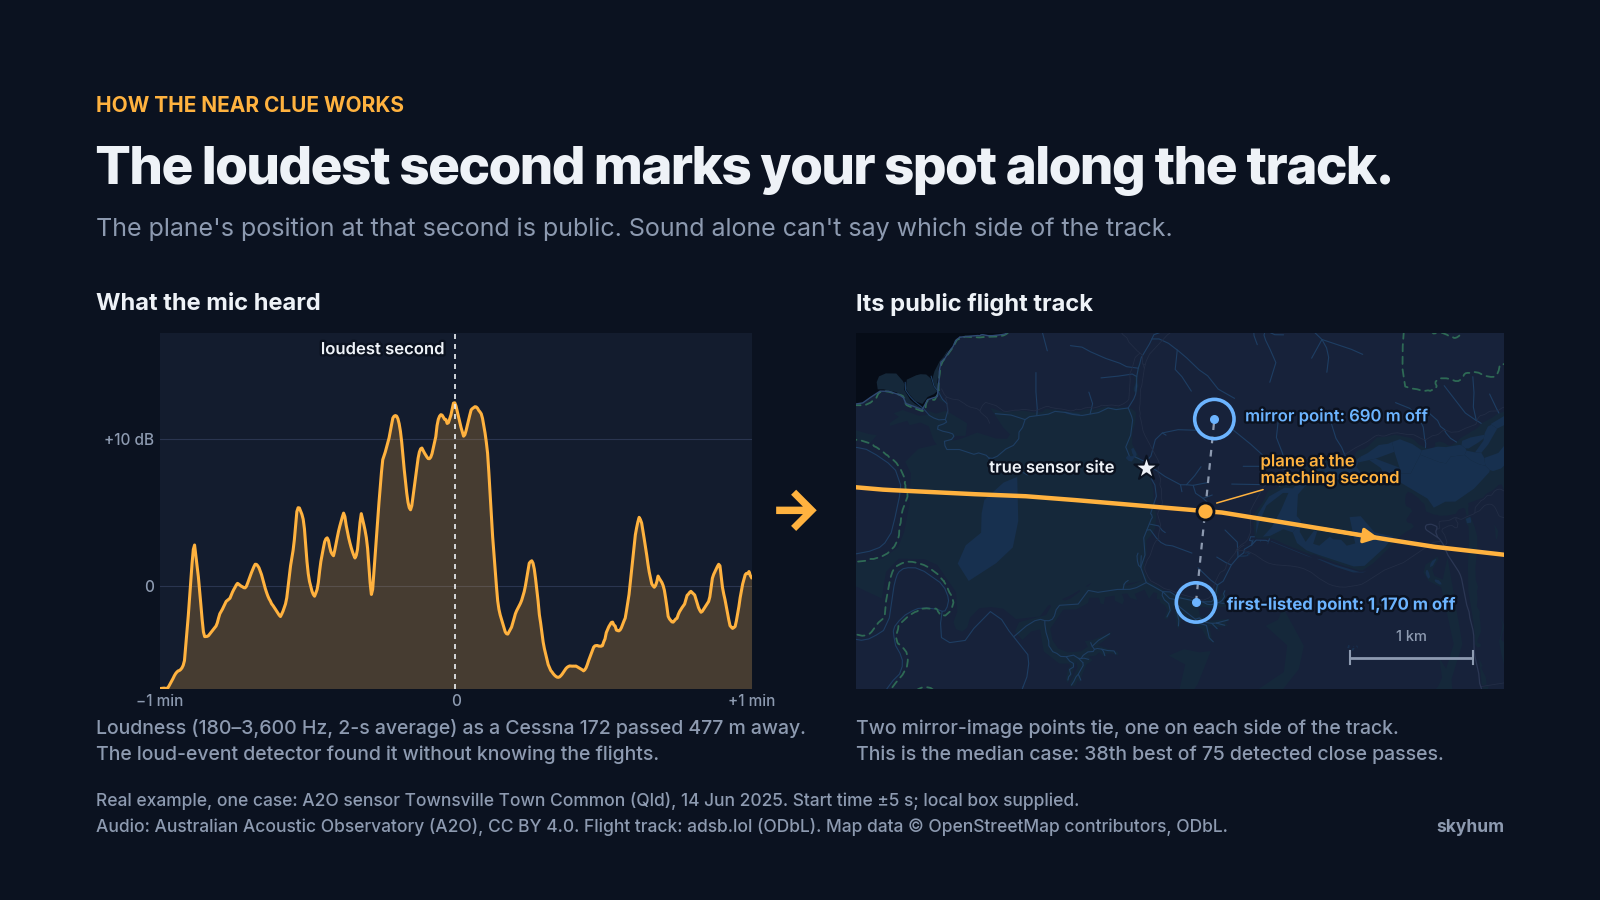 近处线索的原理,使用真实数据。左:一架 Cessna 172 从距澳大利亚某传感器 477 m 处飞过时的响度(昆士兰州汤斯维尔,2025 年 6 月 14 日),在最响的那一秒达到峰值。右:地图上它的公开航迹,标出了飞机在那一秒的位置、传感器的真实位置,以及定位器给出相同分数的两个镜像点,分别距该站点 690 m 和 1,170 m。这是 75 次被检测到的近距离飞越中的中位数案例。
经过应用重放之后还剩下什么
**四站点测试。**我们从四个户外公开摄像头直播流中各取四小时的声音,以数字方式经 Telegram Desktop 和 Google Meet(在 Chrome 中)重放,不叠加人声。开始时间已知,误差在五秒以内,并且搜索时被告知哪四个小时来自同一站点。
**逐次飞越测试。**我们使用了澳大利亚乡村传感器录音中 19 次已知的飞机飞越(与上面四个摄像头站点不是同一个样本)。我们事先给它们做了标注,把音频以数字方式送入桌面客户端(Telegram Desktop、Zoom,以及 Chrome 中的 Meet),再用一个自动化测试在输出中检查同样的飞越。图中“原始片段”一行是对照组:同样的飞越在送入应用之前的结果。不叠加人声时它必然是 19 次中的 19 次,因为我们选的就是测试能识别出飞越的片段。
不叠加人声时,我们的自动化测试在 Telegram 上识别出 19 次飞越中的 17 次,在 Meet 上识别出 19 次中的 13 次。当我们加入一个说话人(一条录制的朗读语音,60% 的时间在说话,比背景高 30 dB)时,即使在送入任何应用之前的原始片段上,测试也只识别出 19 次中的 2 次。传输之后,两个应用上都是 19 次中的 0 次。
Zoom 的默认降噪保留了 19 次飞越中的 0 次,7 段响亮的近距离片段中有 0 段还能看到声浪。在为音乐人准备的“Original sound”模式下,这两个数字是 19 次中的 17 次和全部 7 段响亮片段。响亮的近距离片段在其他应用上表现也不错:没有说话人时,我们的全部 12 段(9 段喷气机、3 段螺旋桨飞机,经过电平归一化)在 Telegram 和 Meet 上都仍然可见。
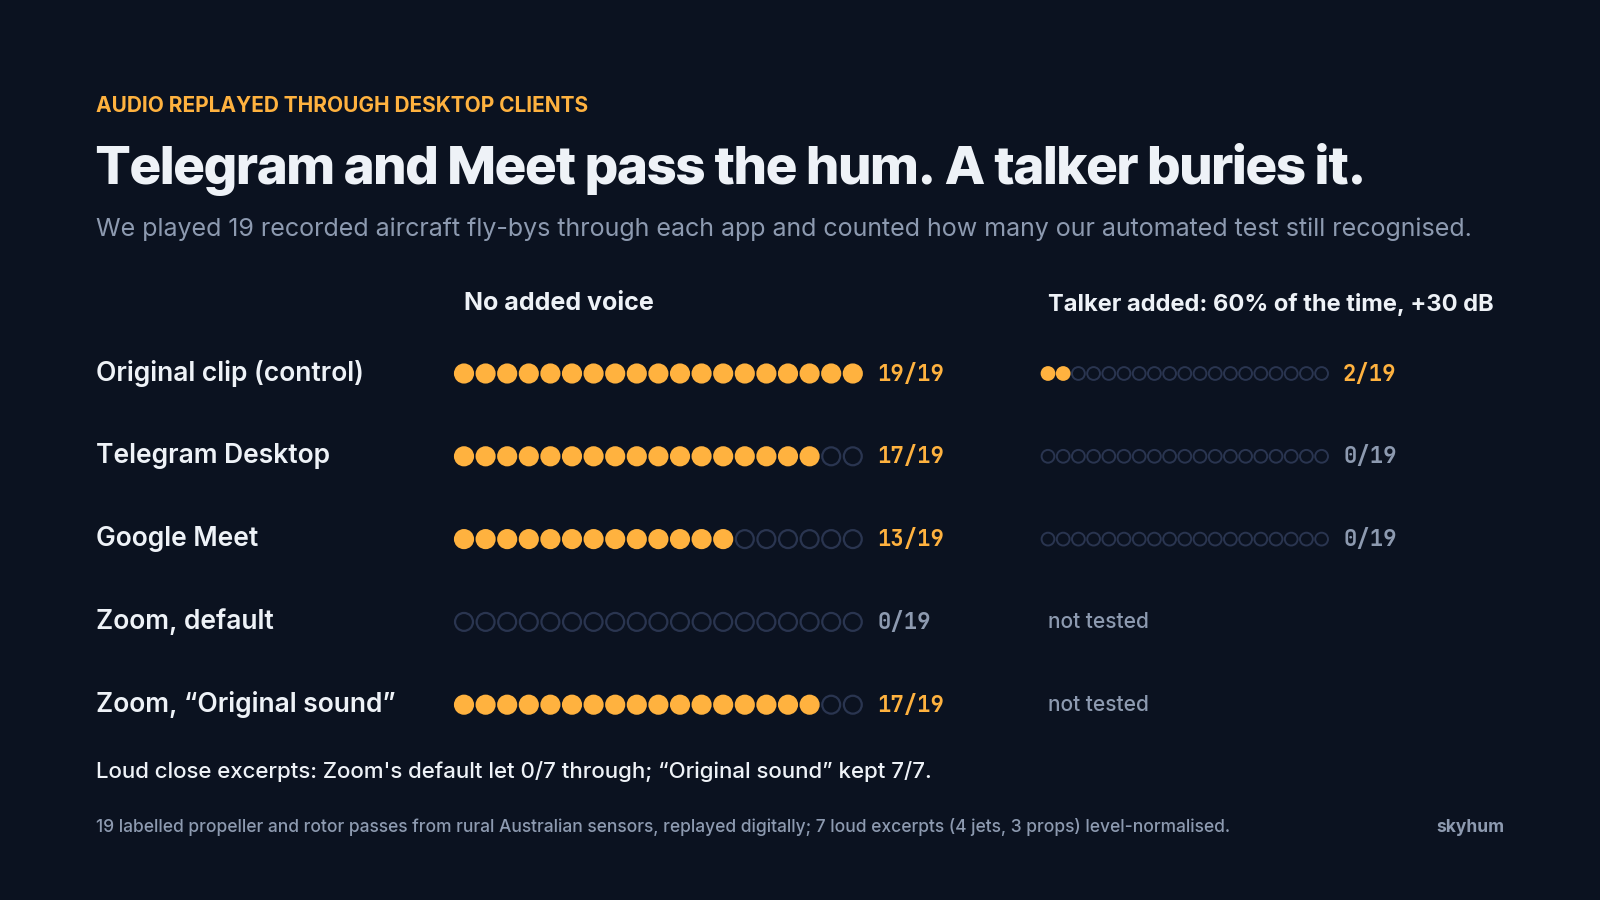 我们的自动化测试识别出的已知飞机飞越,共 19 次。不叠加人声:原始片段 19/19,Telegram Desktop 17/19,Google Meet 13/19,Zoom 默认 0/19,Zoom Original sound 17/19。加入说话人,60% 的时间在说话,+30 dB:原始片段 2/19,Telegram 0/19,Meet 0/19;Zoom 没有在有说话人的条件下测试。响亮的近距离片段:Zoom 默认 0/7,Original sound 7/7。
在这些经 Telegram 和 Meet 的户外重放中,只有不叠加人声时飞越才能被识别出来:Telegram 上 19 次中的 17 次,Meet 上 19 次中的 13 次,而加入说话人后两者都是 19 次中的 0 次。
一小时的嗡鸣输给了猜纽约;小时数多了才有帮助
我们在美国本土范围内搜索美国基准测试中 327 段一小时录音各自的来源(摄像头、活动直播和户外讲话;其中 36 段是加拿大的活动小时,任何方法都不可能答对,它们算作未命中)。我们知道开始时间,误差在五秒以内。嗡鸣把正确区域排在第一 15 次(5%)。每次都回答“纽约”能对 50 次(15%)。猜录音所在时区里最大的都会区,在 327 个案例中对了 87 个(27%)。这种猜法占了时区的便宜,而只靠声音的搜索没有这个信息。保留时区猜测,除非声音的结果胜过所有诱饵,这样能把数字提高到 89。
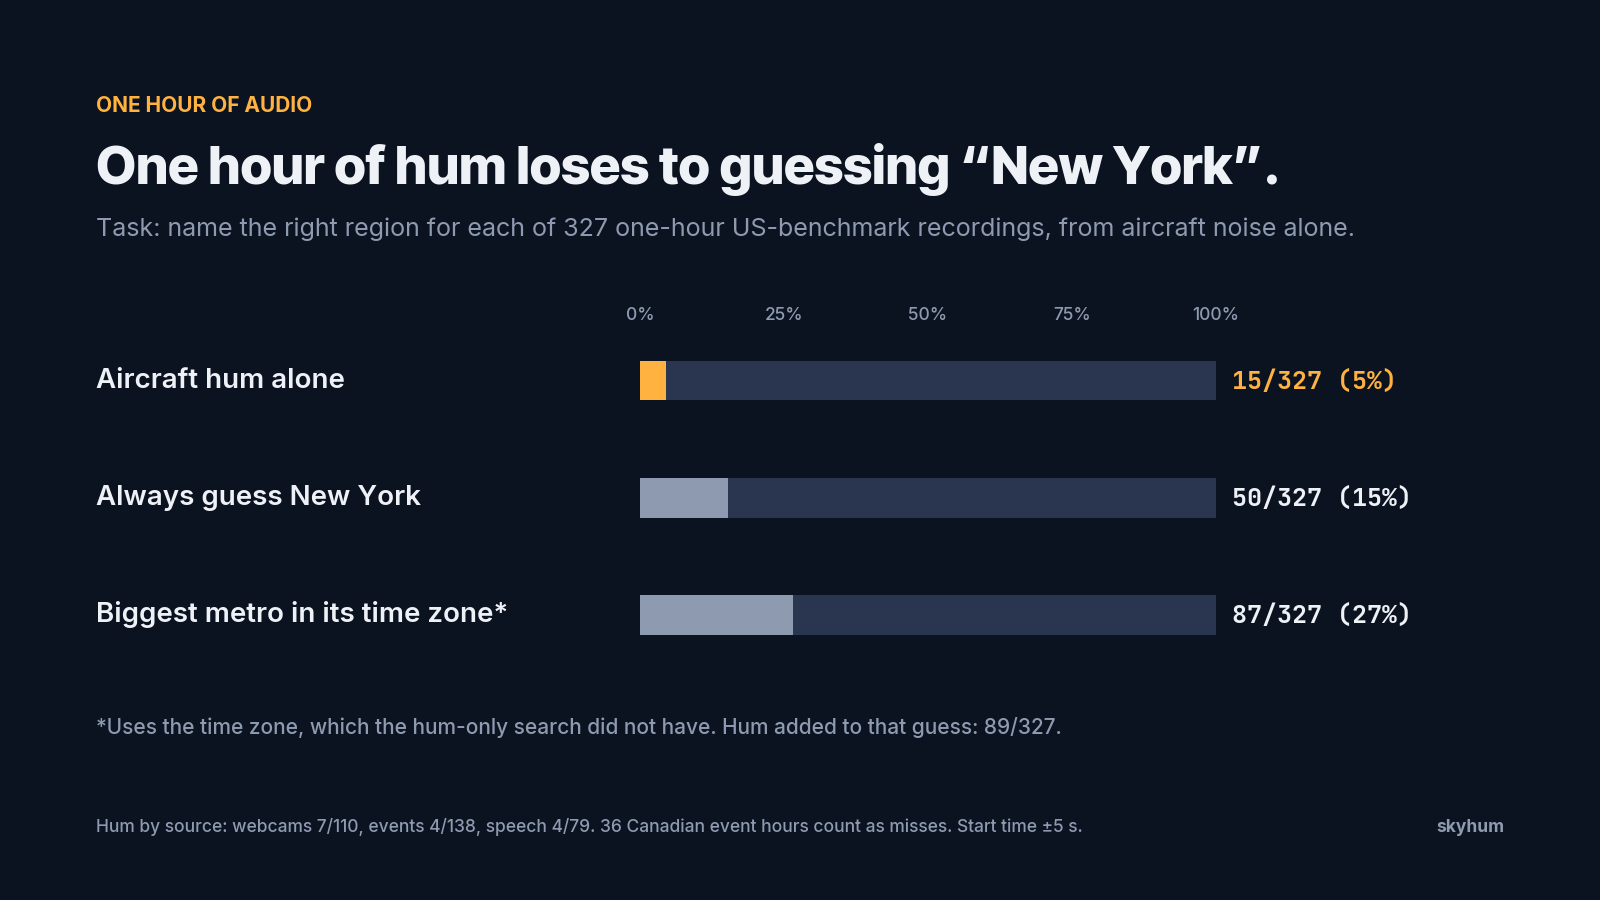 美国基准测试的 327 段一小时录音中正确区域排在第一的情况(36 段加拿大活动小时算作未命中)。仅靠飞机嗡鸣 15/327(5%)。总是猜纽约 50/327(15%)。录音所在时区里最大的都会区 87/327(27%),这用到了时区;在这个猜测上加入嗡鸣 89/327。嗡鸣按来源分:摄像头 7/110,活动 4/138,讲话 4/79。
在澳大利亚乡村传感器上,录音很安静,嗡鸣在 139 个小时中有 37 个(27%)把正确区域排在第一。按人口来猜在那里的得分是 0。
对于重复的录音,我们告诉搜索哪些录音来自同一个地点,但不透露位置。每组录音算作一个答案。
- 对澳大利亚传感器,正确区域排在第一的情况是:单个小时 37/139,两段一组 32/68,四段一组 23/32,八段一组 13/14(8 个站点)。
- 对美国摄像头,同样顺序的数字是 7/110、7/52、6/24 和 3/8(7 个站点)。
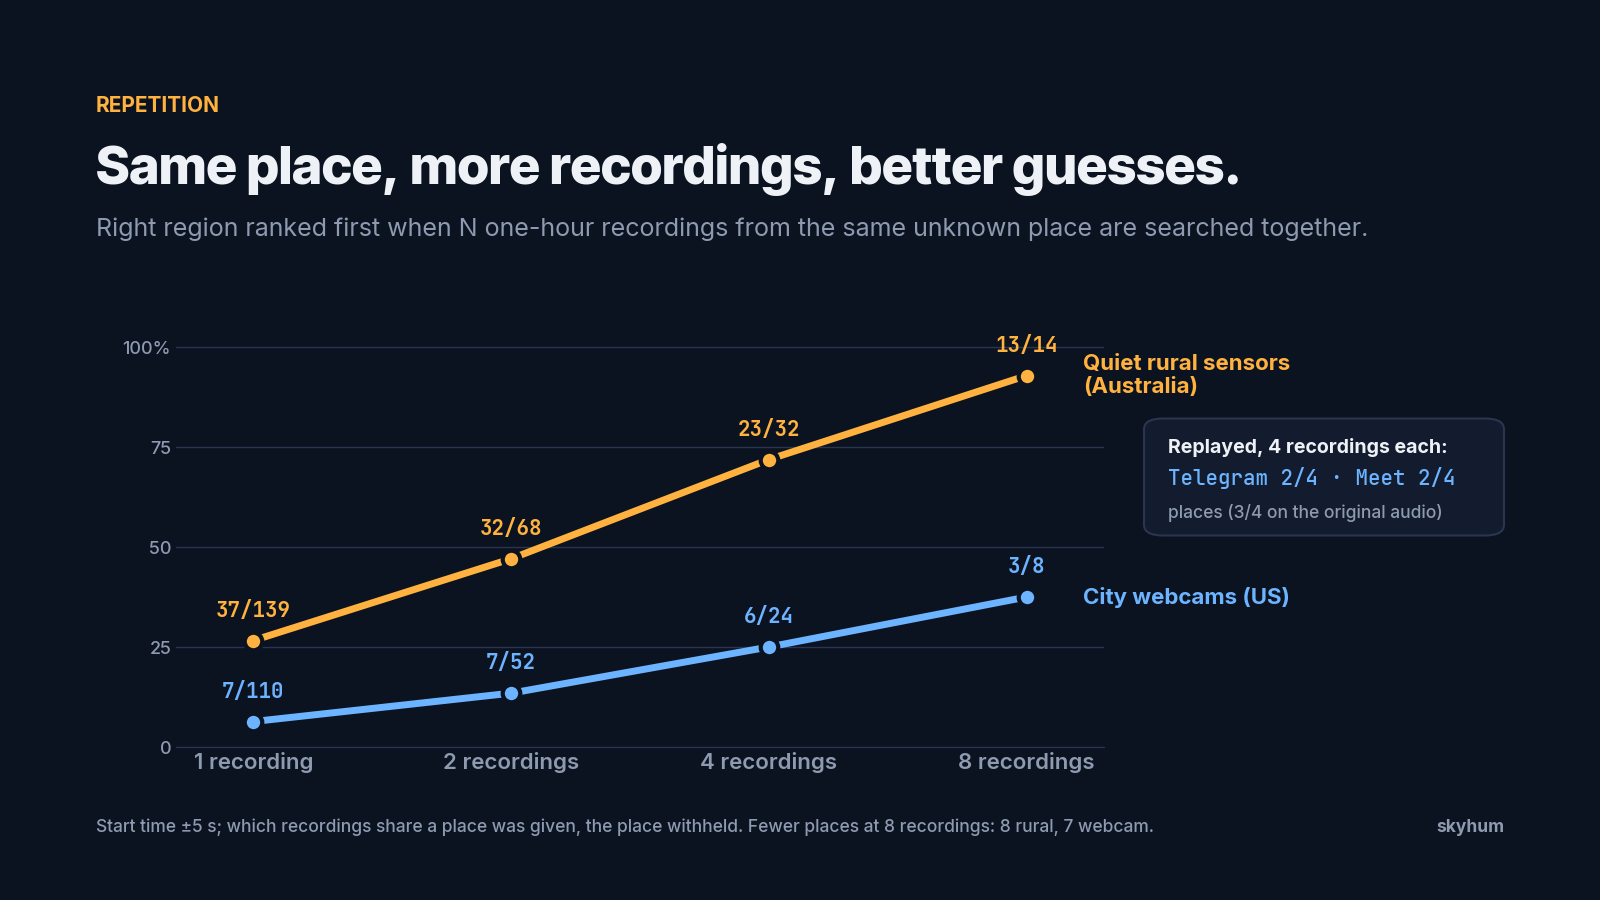 根据同一未知地点的 1、2、4、8 段一小时录音,把正确区域排在第一的情况。澳大利亚乡村传感器:37/139、32/68、23/32、13/14。美国城市摄像头:7/110、7/52、6/24、3/8。4 段录音时经 Telegram 和 Meet 重放:Telegram 2/4、Meet 2/4 个站点组,而原始音频是 3/4。8 段录音时站点更少:乡村 8 个,摄像头 7 个。
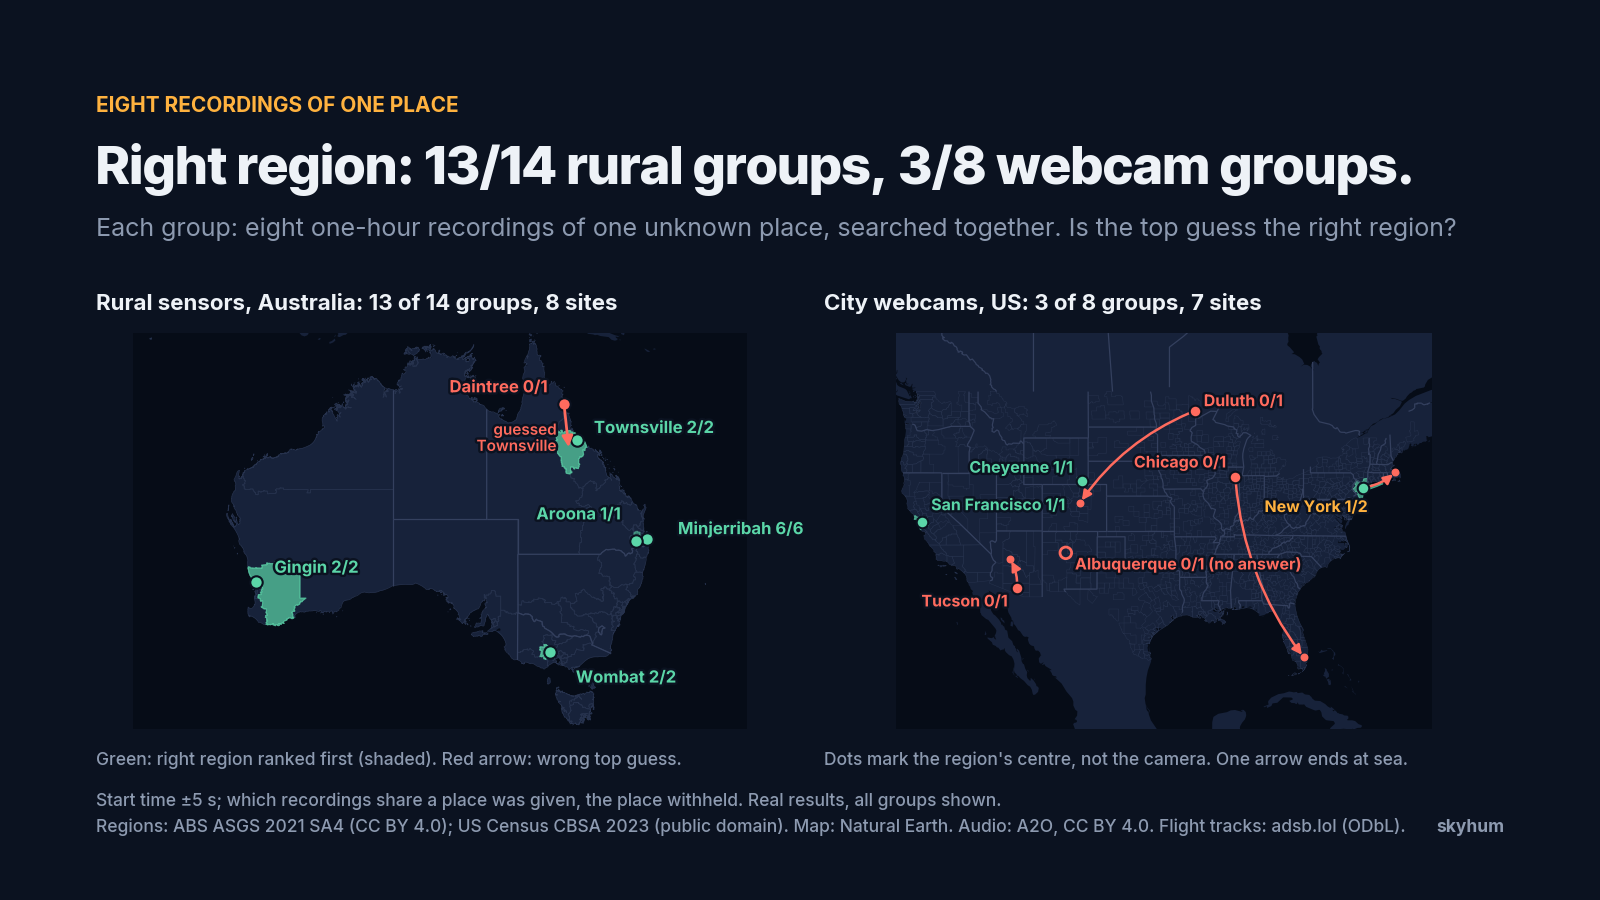 八段录音的结果在地图上落在哪里。澳大利亚:14 组中有 13 组把正确区域排在第一,来自 8 个传感器站点;唯一的未命中是昆士兰最北部的一组,它给出的是汤斯维尔。美国:8 个摄像头组中有 3 个正确,来自 7 个站点;未命中的几组把德卢斯说成丹佛,把图森说成普雷斯科特谷,把芝加哥说成迈阿密,纽约的一组给出了海上的一个点,阿尔伯克基没有给出答案。标记位于区域中心,而不是摄像头所在位置。
最大的几组来自太少的站点,具体比例不能太当真。把多个小时合在一起也让位置更精确:都会区已知、没有时钟时,落在 2 km 以内的比例从一小时的 10% 升到四小时的 24% 和八小时的 52%(35 组)。有 ±30 s 的时钟时,从 15% 升到 47% 和 67%(11 组)。哪些小时来自同一站点是给定的,我们也没法测量这些合并后的答案有多少是自信但错误的。在通话测试中,每个站点四小时为一组,在 Telegram 和 Meet 每个应用上都是 4 个站点中有 2 个给出了正确的都会区,而同样的音频在发送之前是 4 个中的 3 个。这个对比的样本只有四个站点。
会议有一样播客没有的东西:时钟
上面所有全国范围的结果都假设我们知道录音的开始时间,误差在五秒以内。会议把这个信息白送给了分析者:开始时间就在日历条目、入会日志或云录制的时间戳里,通常精确到秒。播客或公开活动的录音通常只有一个发布日期或一个大致的时间窗口。
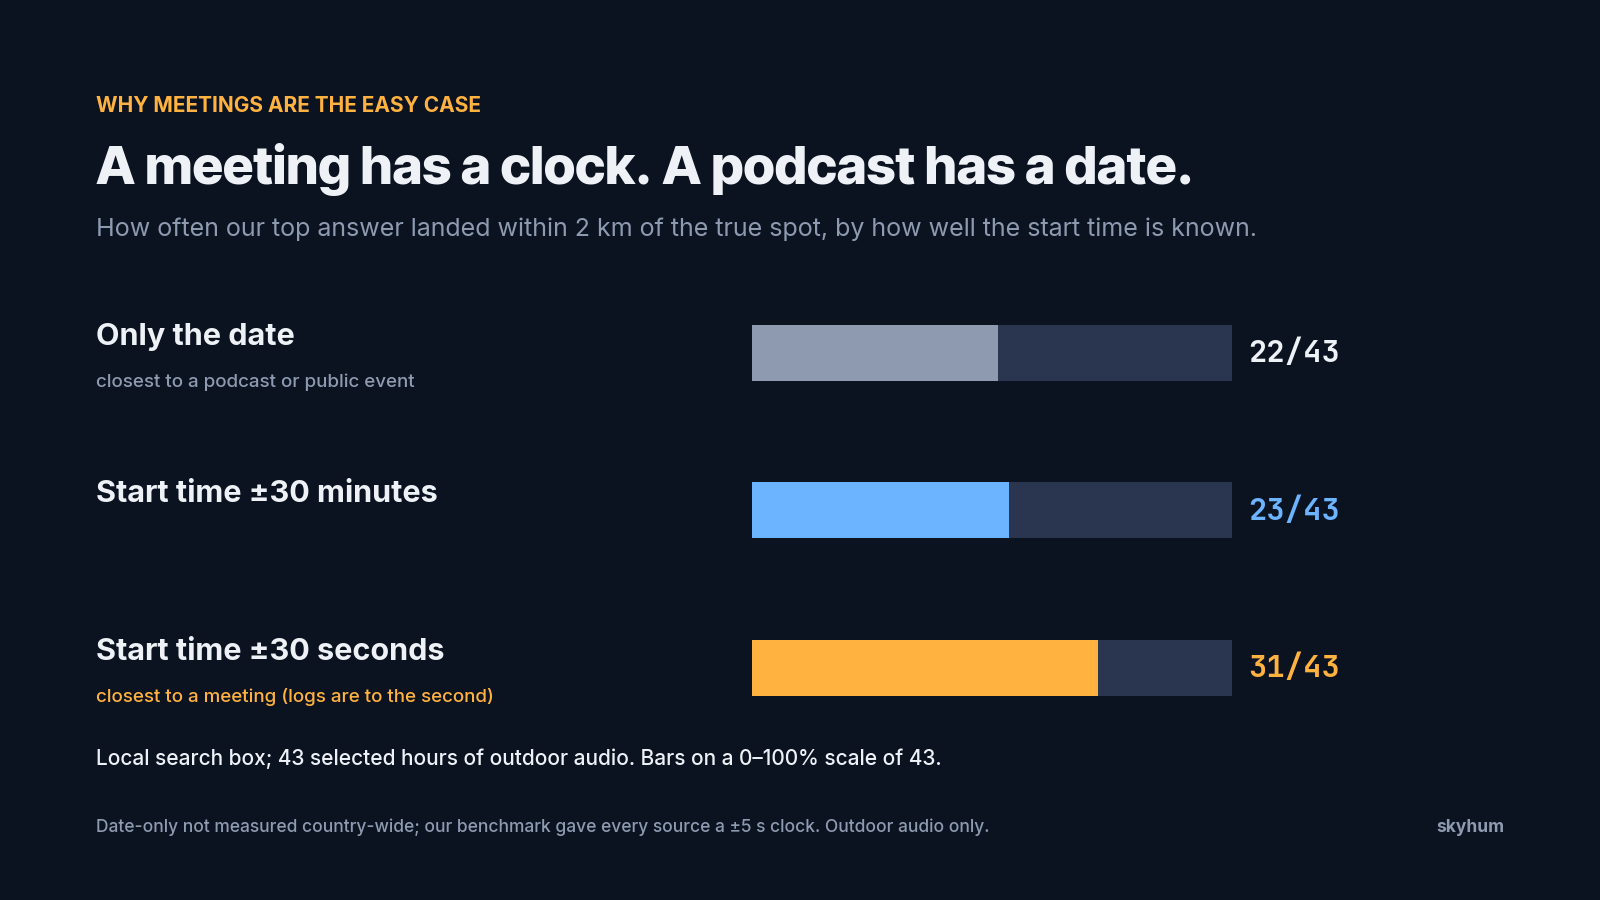 在有本地搜索框的 43 个选定小时中,首选答案落在真实地点 2 km 以内的数量,按对开始时间的了解程度分:只知道日期 22;开始时间误差在 30 分钟以内 23;30 秒以内 31。只知道日期的一行最接近播客或公开活动;30 秒的一行最接近会议。
**从半小时到半分钟多了 8 个小时。从只有日期到半小时只多了一个。**我们从没有在只知道日期的条件下跑过全国范围的搜索,所以播客和活动录音的得分会比我们的基准测试显示的更低:我们给每个来源都提供了五秒精度的时钟。会议最符合我们的假设,但有一点要说明:我们只测试了户外音频。
一次被检测到的近距离飞越可以定位到一公里以内
下面 75 次飞越和 70 小时的距离结果都以检测到一次近距离飞越为条件。
我们有 75 个来自澳大利亚乡村传感器的案例,其中确实有飞机近距离飞过,而且被我们的响声事件检测器捕捉到了。搜索时在真实站点周围有一个本地搜索框,并假定了站点的地面高度。我们知道开始时间,误差大约五秒。
- 两个镜像点之一,也就是排在前面列出的那个,在 43% 的飞越中落在 1 km 以内,在 63% 的飞越中落在 2 km 以内。在 75 次飞越中的 73 次里,两个点的分数完全相同,所以先列哪一个是任意的。
- 如果取两个点中更近的那个,59% 在 1 km 以内。我们是用真实站点来挑选更近的那个的,所以对单一答案来说这是上限。一个把两个点都报出来的监听者,会有这么高的比例让其中一个点落在 1 km 以内。
- 使用包含该次飞越的整个小时(70 个选定小时),我们在 60% 的案例中落在 2 km 以内。当我们只知道开始时间到 ±30 s 时,这个数字降到 51%。
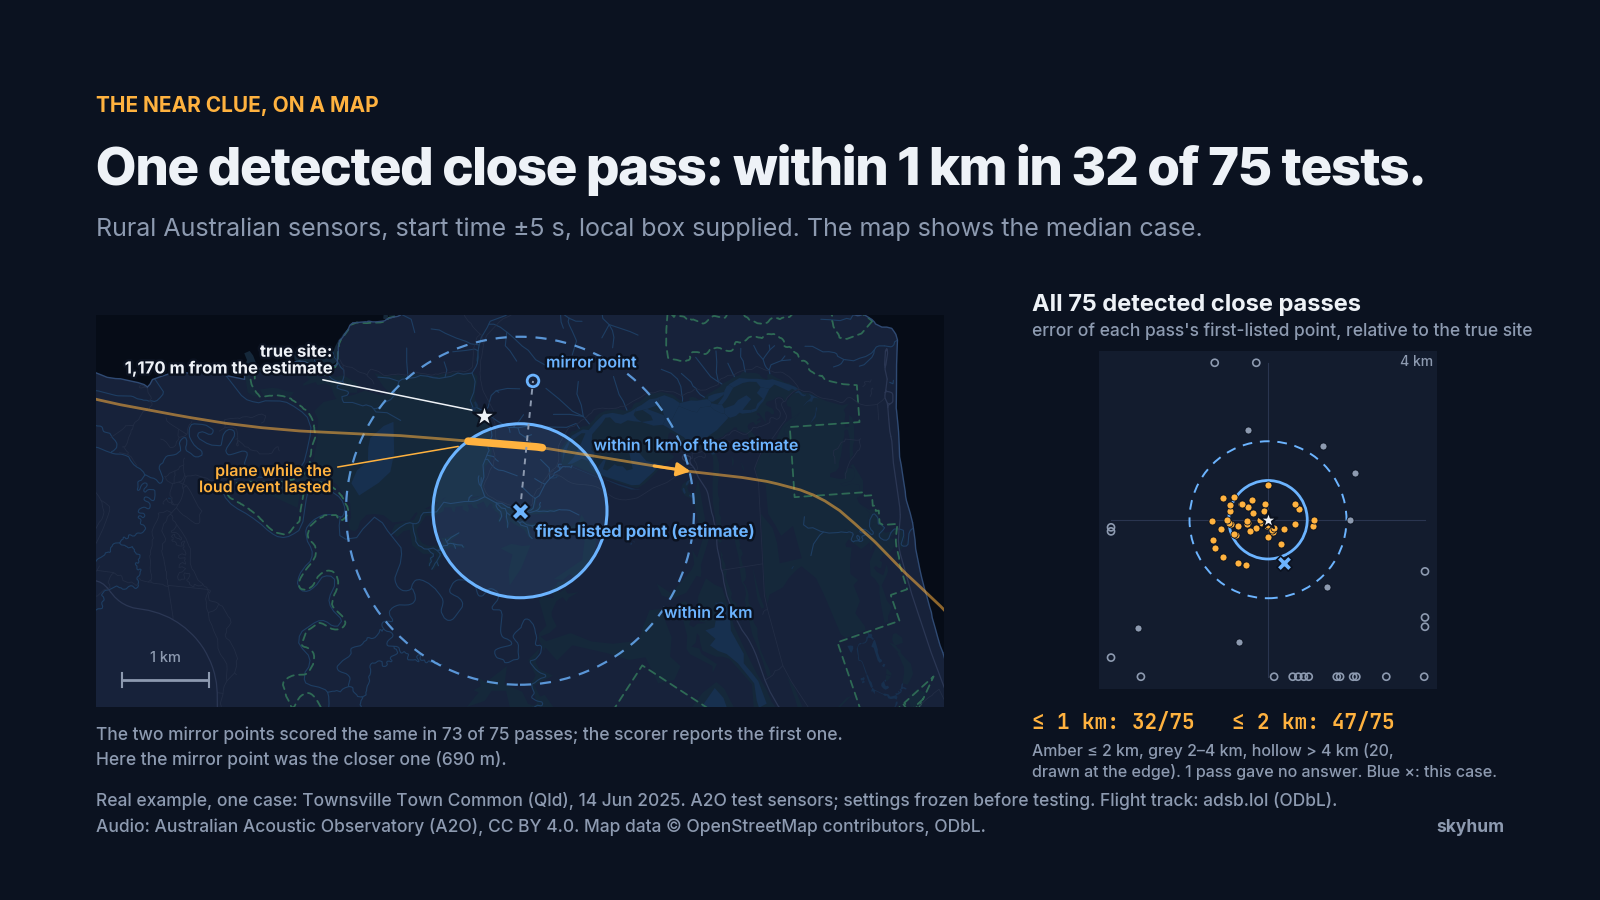 地图上的中位数近距离飞越。估计点周围 1 km 和 2 km 的圆,真实站点在 1,170 m 外,还有飞机的航迹以及在检测到的响声事件期间飞过的那一段。右:全部 75 次被检测到的近距离飞越中排在前面列出的点相对真实站点的误差:32 个在 1 km 以内,47 个在 2 km 以内。
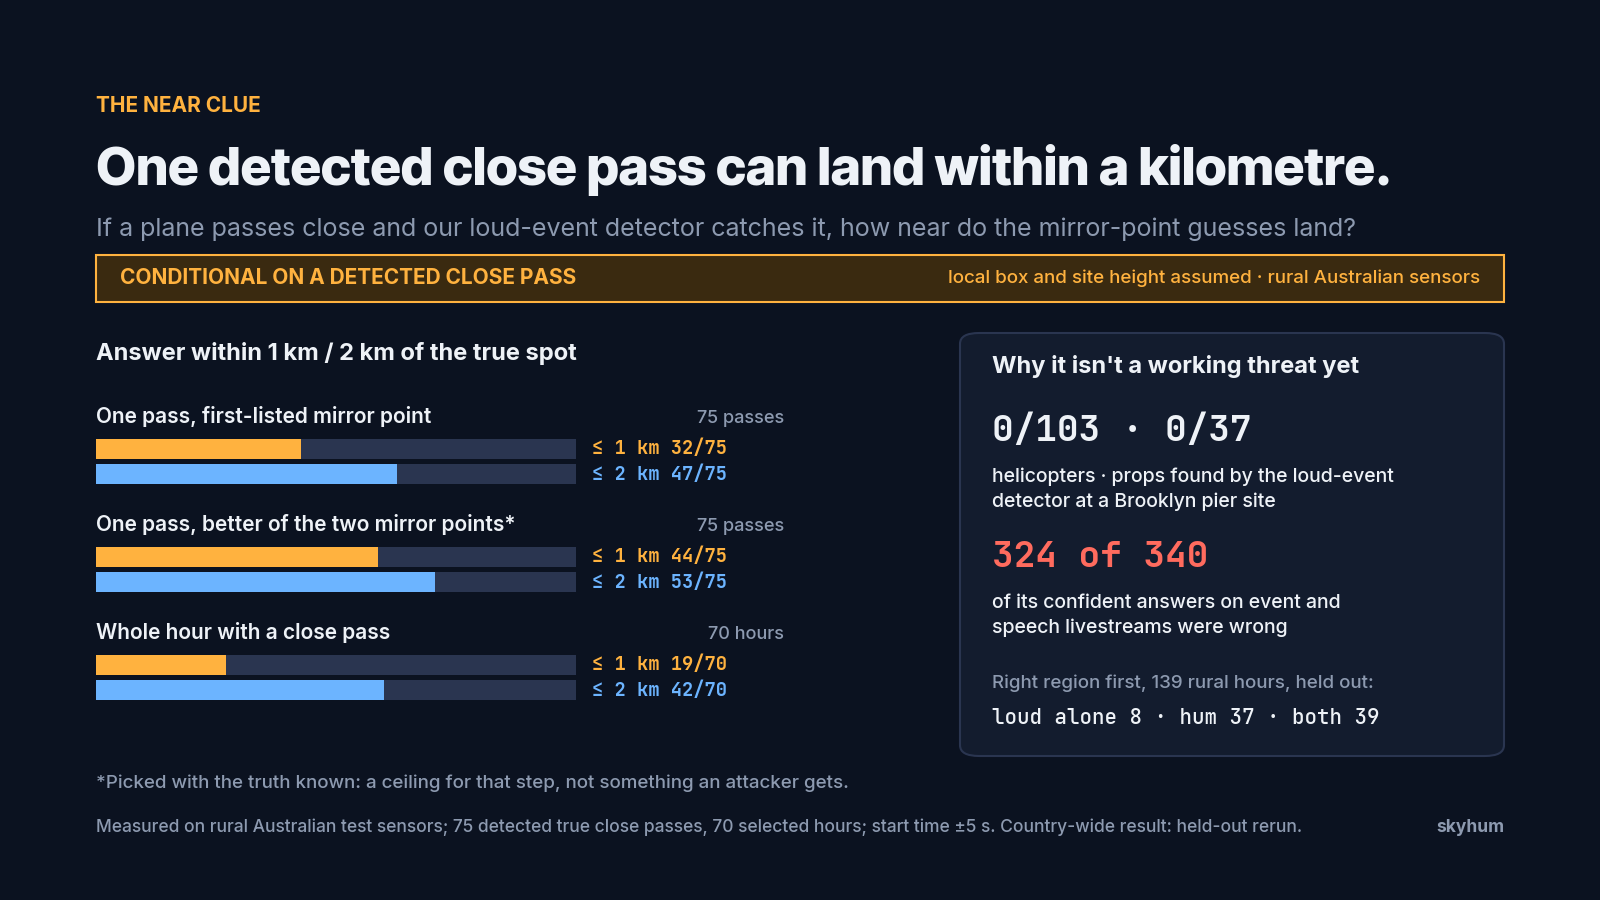 以检测到一次近距离飞越为条件;假定了本地搜索框和站点高度;澳大利亚乡村传感器。一次飞越,排在前面列出的镜像点:1 km 以内 32/75,2 km 以内 47/75。一次飞越,两个镜像点中较好的那个,在已知真实位置的情况下挑选:44/75 和 53/75。包含一次近距离飞越的整个小时:19/70 和 42/70。为什么它还不是一个现实可用的威胁:在布鲁克林一个码头站点,响声事件检测器找到 0/103 架直升机和 0/37 架螺旋桨飞机;在活动和讲话直播上,它给出的 340 个自信的 10 分钟答案中有 324 个是错的;在留出的 139 个澳大利亚乡村小时中正确区域排在第一:仅响声 8,嗡鸣 37,两者合用 39。
我们能在 54 个小时上比较这两条线索,搜索在本地搜索框内进行,开始时间已知到 ±30 s。嗡鸣把 19 个小时定位到 2 km 以内,响声通道把 14 个小时定位到这个距离以内,其中有 4 个小时是共同的。两者合起来覆盖了 54 个中的 29 个,而仅靠嗡鸣是 19 个。这个并集是我们事后统计的,用已知站点分别给每组答案打分。在这个比较中我们并没有运行一个合并的系统。
三项实测的局限使它今天还不能当作通用的定位器来用。
- 在活动和讲话录音上,响声通道在 340 个十分钟窗口中给出了自信的答案。其中 324 个是错的。
- 在布鲁克林一个直升机流量很大的码头站点,响声事件检测器找到了 103 架直升机中的 0 架和 37 架螺旋桨飞机中的 0 架。它是在安静的乡村小时上调出来的,而城市噪声是个更难的问题。
- 在留出的全国范围搜索中,把响声通道加到嗡鸣上几乎没有带来任何变化。单独使用时,响声通道在 139 个澳大利亚单个小时中有 8 个、在 110 个美国摄像头小时中有 2 个把正确区域排在第一,而嗡鸣是 139 个中的 37 个和 110 个中的 8 个。合用时,数字是 139 个中的 39 个和 110 个中的 7 个。在四段和八段录音时,澳大利亚的结果没有变化(23/32 和 13/14),通话测试也保持在未处理时 4 个中的 3 个、每个应用上 4 个中的 2 个。(在这次重跑中,仅靠嗡鸣在摄像头上是 110 个中的 8 个,因为它是在更大的候选集合上打分的;前面的 110 个中的 7 个只用了嗡鸣自己的候选。)权重是我们在看到这些结果之前,在 60 个开发小时上选定的。
就风险而言,重要的是上限:在一次被检测到的近距离飞越上,并且给定了本地搜索范围时,几何关系在我们的乡村测试中是成立的。检测城市里的近距离飞越,以及区分正确答案和错误答案,对我们的响声事件检测器来说仍是未解决的问题。
直升机:最容易听到,最难检测
在我们的城市样本中,直升机是标注器最常找到的飞越(大多在布鲁克林的一个码头),也是我们的盲音调检测器最常漏掉的飞越。
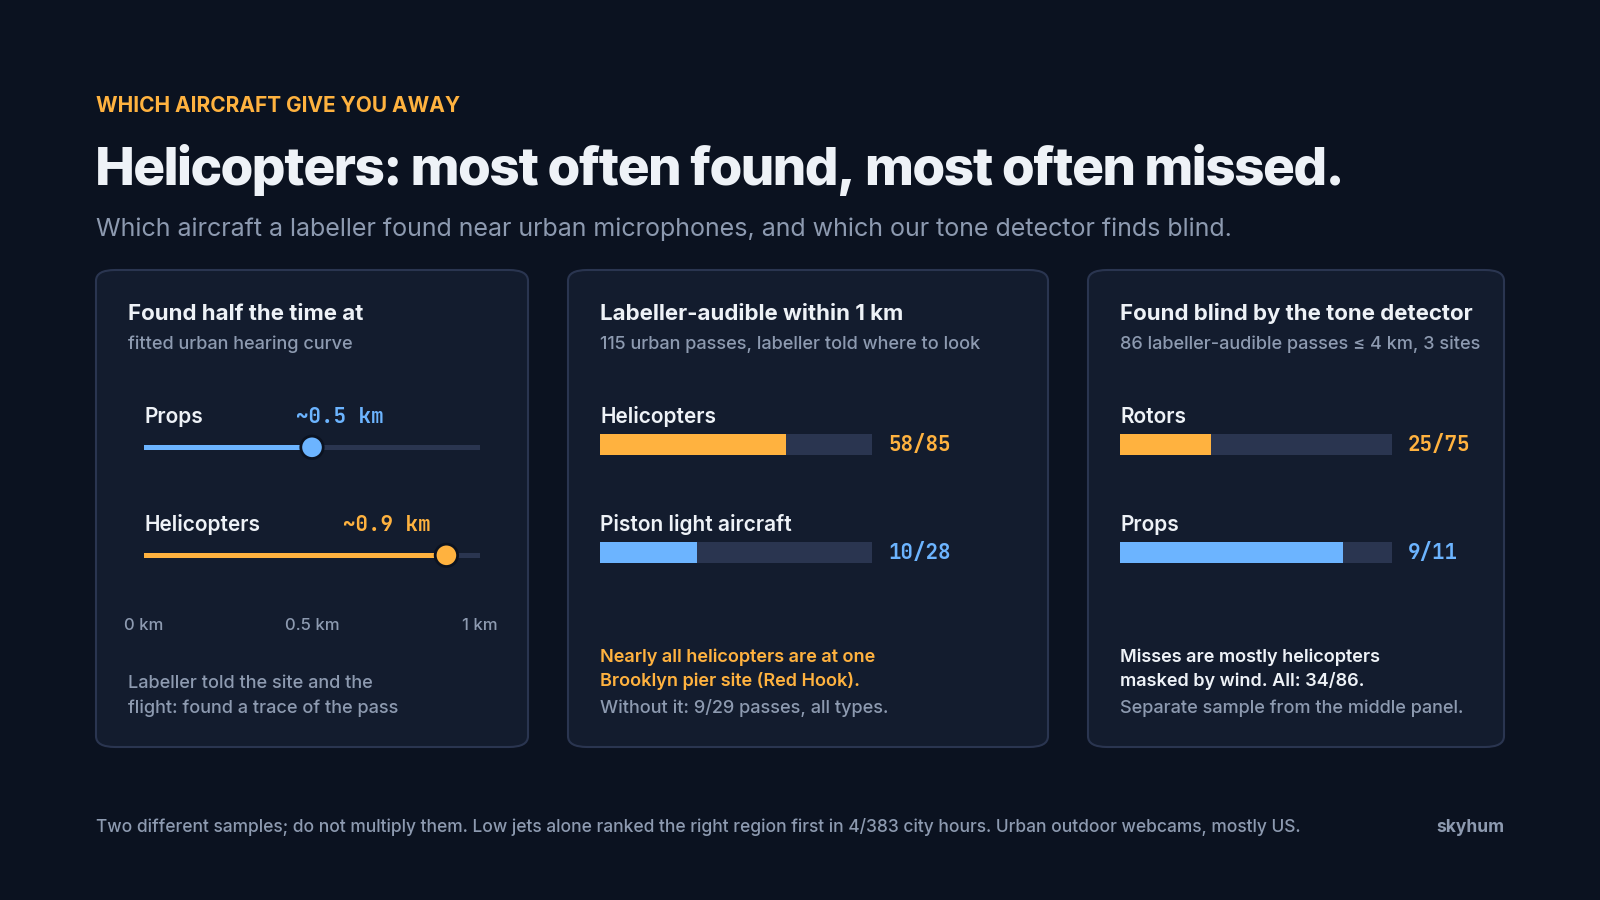 哪些飞机会暴露你,美国城市户外站点。根据拟合的城市听觉曲线,被告知往哪里看的标注器有一半概率找到飞越的距离,螺旋桨飞机约为 0.5 km,直升机约为 0.9 km。115 次城市飞越中 1 km 以内标注器可听到的情况,标注器被告知往哪里看:直升机 58/85,活塞式轻型飞机 10/28;几乎所有直升机都在布鲁克林的一个码头站点(Red Hook);去掉它之后是 9/29 次飞越,所有机型。在另一个样本中,3 个站点 4 km 以内 86 次标注器可听到的飞越里,被音调检测器盲找到的:旋翼机 25/75,螺旋桨飞机 9/11,合计 34/86;漏掉的大多是被风声掩盖的直升机。另外,仅靠低空喷气机在 4/383 个城市小时中把正确区域排在第一。
*多远还能被找到。*我们用对城市摄像头音频的一次自动重新标注拟合了一条听觉曲线。在这条曲线上,自动标注器在被告知往哪里看的情况下找到飞越的概率,对螺旋桨飞机在大约 0.5 km 处降到一半,对直升机在大约 0.9 km 处降到一半。
*近处能听到什么。*在九个城市摄像头站点,有 115 次可评分的飞越进入了 1 km 以内。给定站点和航班的自动标注器能在其中 68 次(59%)中找到痕迹。直升机中,85 架里有 58 架(68%)是标注器可听到的。活塞式轻型飞机的数字是 28 架中的 10 架(36%)。几乎所有直升机都在布鲁克林 Red Hook 的同一个码头站点,所以直升机这个数字按站点自助抽样(bootstrap)得到的区间是 0 到 71%。排除 Red Hook 之后,各机型合计 29 次飞越中有 9 次可以听到。
*盲音调检测器能抓到什么。*我们使用了另一个样本:三个站点 4 km 以内 86 次标注器可听到的飞越。在不知道往哪里看的情况下,我们的音调检测器找到了 34 次(40%),包括 11 架螺旋桨飞机中的 9 架和 75 架旋翼机中的 25 架。在 1 km 以内,它找到了 64 次中的 19 次(30%)。它漏掉的飞越大多是被风声掩盖的直升机。可听率和盲检测率来自不同的样本,所以把它们相乘会得到一个有误导性的比例。
*喷气机。*仅靠低空喷气机,在 383 个城市摄像头小时中有 4 个(1%)给出了正确区域,在两个测试机场旁边的 16 个小时中有 3 个。在 219 个匹配的基准测试小时上,嗡鸣对了 15 个,喷气机对了 4 个,两者合用对了 17 个。
按我们的默认规则,核验一个声称的区域比找出它更容易
对美国摄像头的单个小时,我们的默认核验接受了 110 个真实区域声称中的 18 个(16%)。从零开始的搜索在 110 个中找对了 7 个。核验还接受了 110 个错误声称中的 2 个(1.8%),这些错误声称说的是最近的另一个区域(在美国是至少有 250,000 名居民的;在澳大利亚是最近的另一个 SA4)。在 139 个澳大利亚传感器小时中,搜索把 37 个放在了正确区域。核验接受了 52 个真实声称和 6 个错误的相邻区域声称。
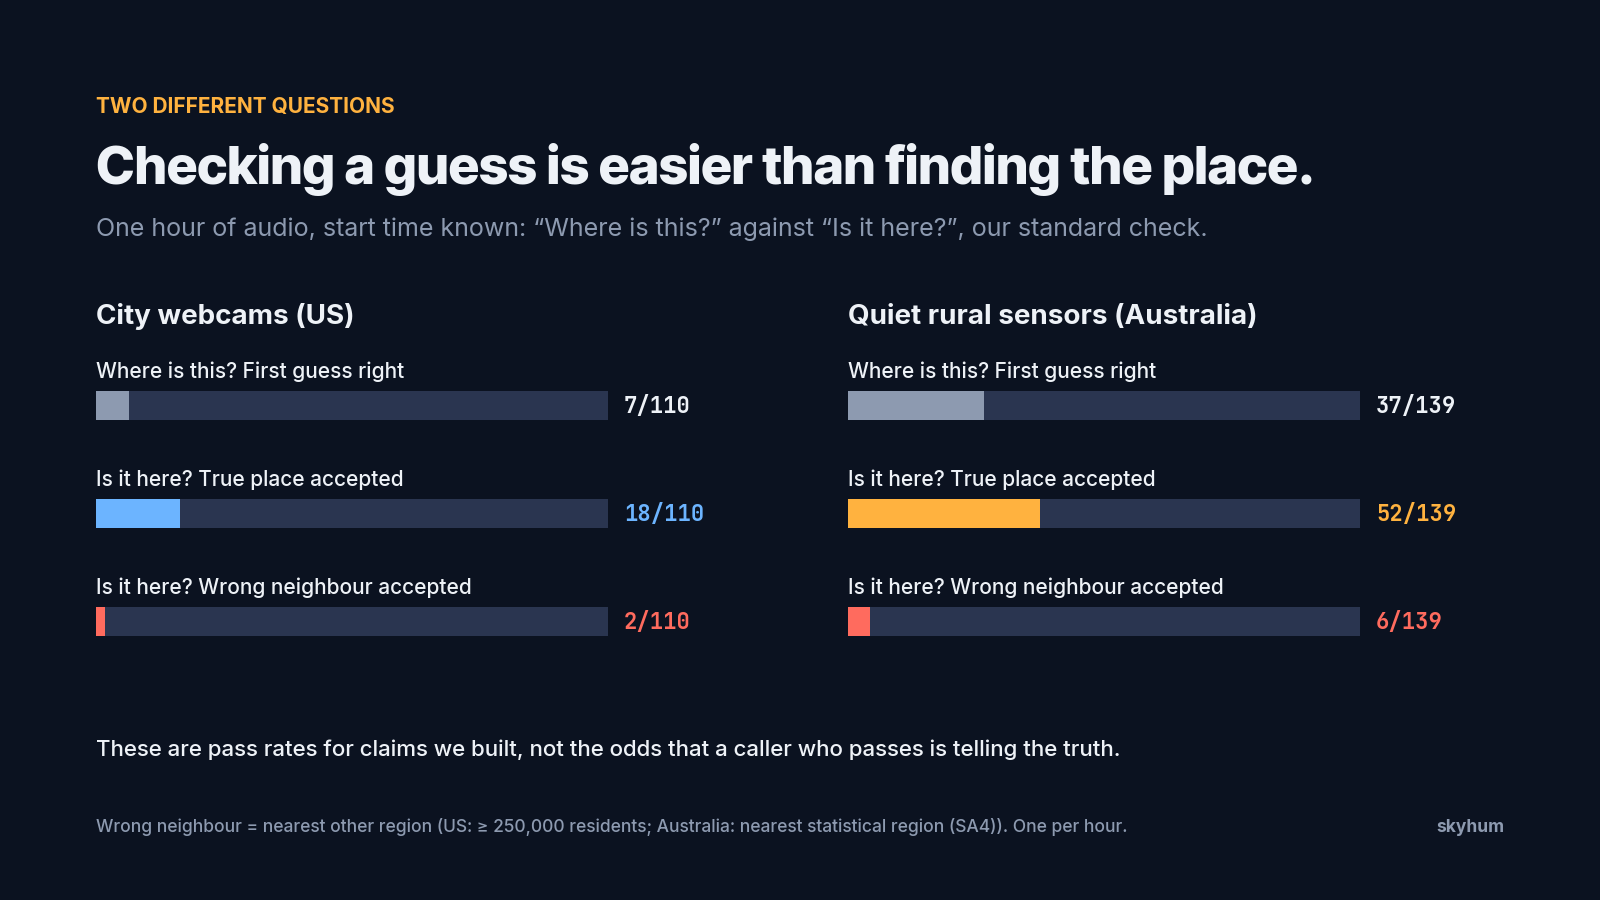 找出地点与核验声称的对比,一小时,默认规则。美国城市摄像头:首个猜测正确 7/110,真实地点被接受 18/110,错误的相邻地点被接受 2/110。安静的澳大利亚乡村传感器:37/139、52/139、6/139。这是我们构造的声称的通过率,不是一个通过核验的通话者说了实话的概率。
相邻的地点可能很难区分。核验没通过说明不了多少问题,因为核验拒绝了 110 个真实摄像头声称中的 92 个。我们测量的是它接受我们构造的声称的频率。要知道一个通过核验的通话者说了实话的概率,你还需要知道人们会怎么声称。
模型估算的概率在小型机场附近更高
在都会区已知、开始时间已知到 ±30 s 的条件下,我们对用一个安静的户外白天小时把麦克风定位到 2 km 以内的概率做了建模。这些数字是模型估算的,并且假设每一次可听到的飞越都被检测到。
对每个都会区的中位陆地点,估算值从旧金山的 3.0% 到洛杉矶盆地的 22% 不等。模型在小型机场和直升机航线附近给出的数字更高,包括一些公共公园,比如范奈斯机场(KVNY)旁的 Lake Balboa 是 54%,曼哈顿的 The Battery 是 58%。六个具名地点的模型估算值在 51–58%。
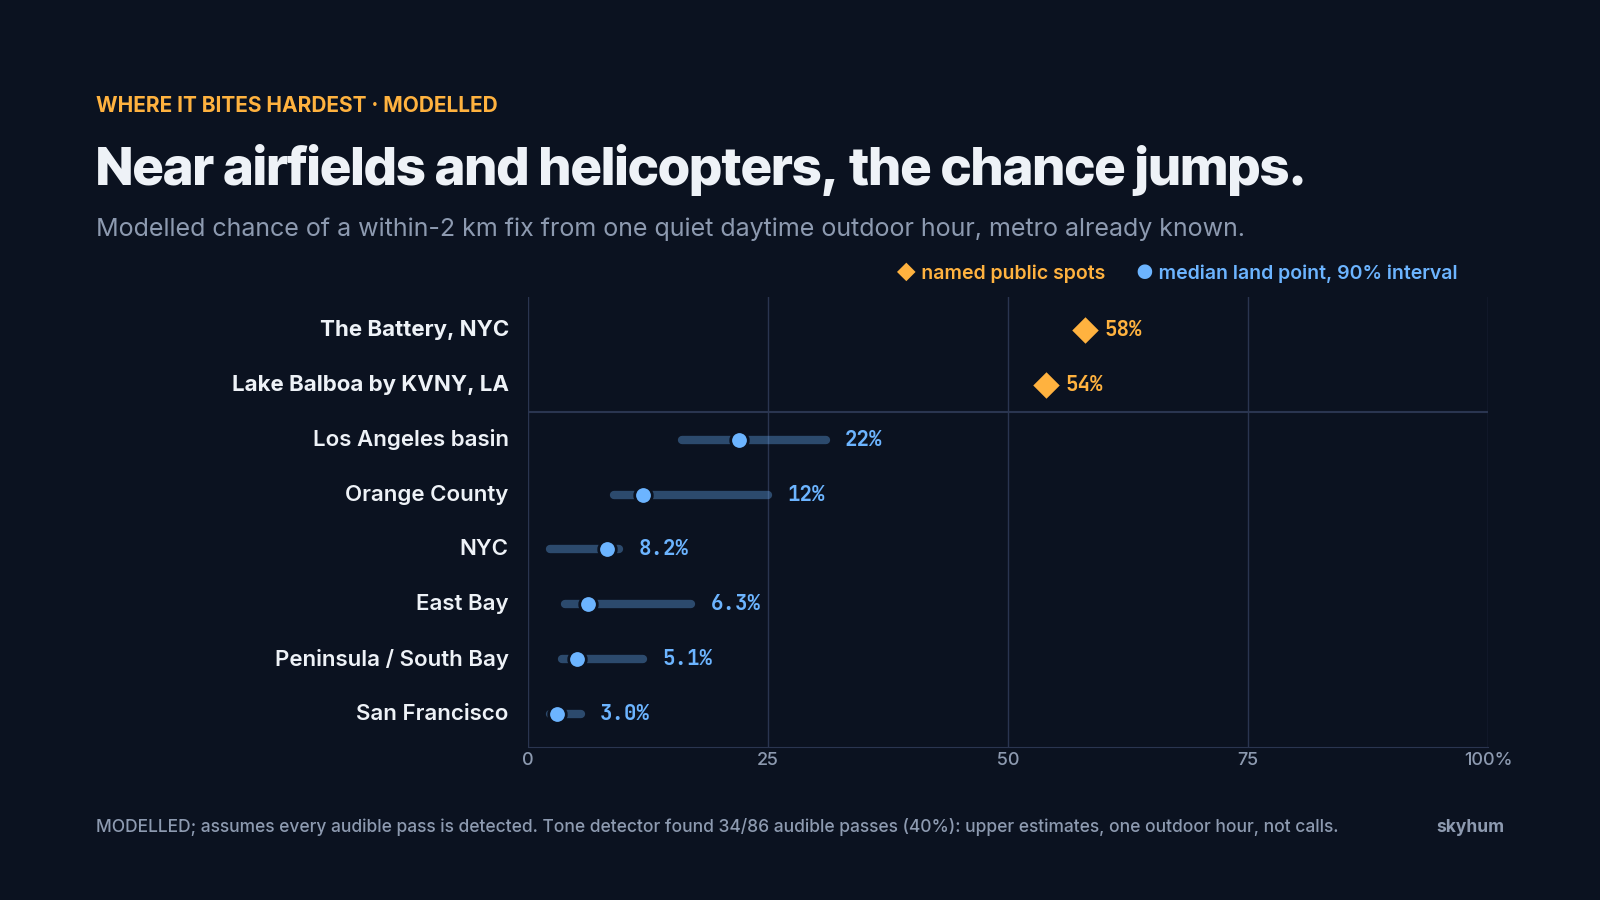 模型估算的概率:都会区已知,用一个安静的白天户外小时定位到 2 km 以内,假设每一次可听到的飞越都被检测到。具名地点:纽约 The Battery 58%;洛杉矶 KVNY 旁的 Lake Balboa 54%。中位陆地点及中位数的 90% bootstrap 区间:洛杉矶盆地 22%(16–31),橙县 12%(9–25),纽约 8.2%(2.3–9.5),东湾 6.3%(3.9–17),半岛和南湾 5.1%(3.5–12),旧金山 3.0%(2.3–5.5)。
我们的音调检测器在另一个样本中找到了 40% 的标注器可听到的飞越,所以应该把这些数字看作模型假设下的上限估计,针对的是一小时户外的原始麦克风音频,而不是从公园里打出的一通电话。
**在都会区已知、开始时间已知到 ±30 秒的条件下,我们的定位器在 43 个选定小时中有 31 个把首选答案放在了真实地点 2 km 以内,43 个中有 24 个在 1 km 以内。**这 43 个小时来自七个站点,所以不确定性很大。接着我们测试了它自信但错误的频率,每小时使用 20 个时钟偏移的诱饵。在 ±30 s 时,50 个小时得到了自信的答案,其中 34 个在 2 km 以内(68%,95% 区间 36–87%)。在已知飞机位置的 43 个小时中,有 9 个的自信答案是错的;在完全没有飞机的 12 个小时中,有 1 个它仍然给出了自信的答案。提高置信度门槛没有帮助:精确率保持在 68% 到 73% 之间。在 ±30 分钟时它降到 49 个中的 25 个(51%)。上面模型估算的概率是在这个定位器之前算的,没有重新跑过。
你能做什么,应用又能做什么
- **听的时候静音。**我们没有测试静音本身,但在我们不叠加人声的重放中,大多数已知的飞越在 Telegram(19 次中的 17 次)和 Meet(19 次中的 13 次)上仍然能传过去,所以开着的麦克风就是暴露面。
- **如果你经常在同一个户外地点参加会议,要格外小心。**如果有人能看出几场会议来自同一个地方,它们合在一起的风险比任何单独一场都大。
- **发布敏感影像之前,把环境音轨换掉。**在我们的模拟中,重新编码为 AAC 后线索完好无损。
**有些应用已经无意中把嗡鸣去掉了。**Zoom 的默认降噪没有保留我们 19 次飞越中的任何一次,而它为音乐人打造的“Original sound”模式让其中 17 次回来了。Telegram 和 Meet 保留了其中的大多数。
**应用可以在说话的停顿期间压低 400 Hz 以下的频段,同时仍然保持麦克风开启。**我们在 53 个选定的安静乡村小时上离线模拟了这种做法,每个小时至少有两次标注过的飞越,不叠加人声,并提供了局部范围和开始时间。使用未处理的音频时,53 个小时中有 32 个被定位到 2 km 以内。加上停顿滤波器后,这个数字降到 53 个中的 4 个,在两项语音质量测试上的语音代价可以忽略(PESQ-WB 中位数低 0.02,STOI 不变)。擦除飞机音调后还剩 17 个小时在范围内。重新编码后还剩 32 个。停顿滤波器在说话期间帮助不大,而且在每种措施下都有一些响亮的飞越仍然可以检测到。这是模拟,不是真实的应用,真实平台的处理管线表现可能不同。
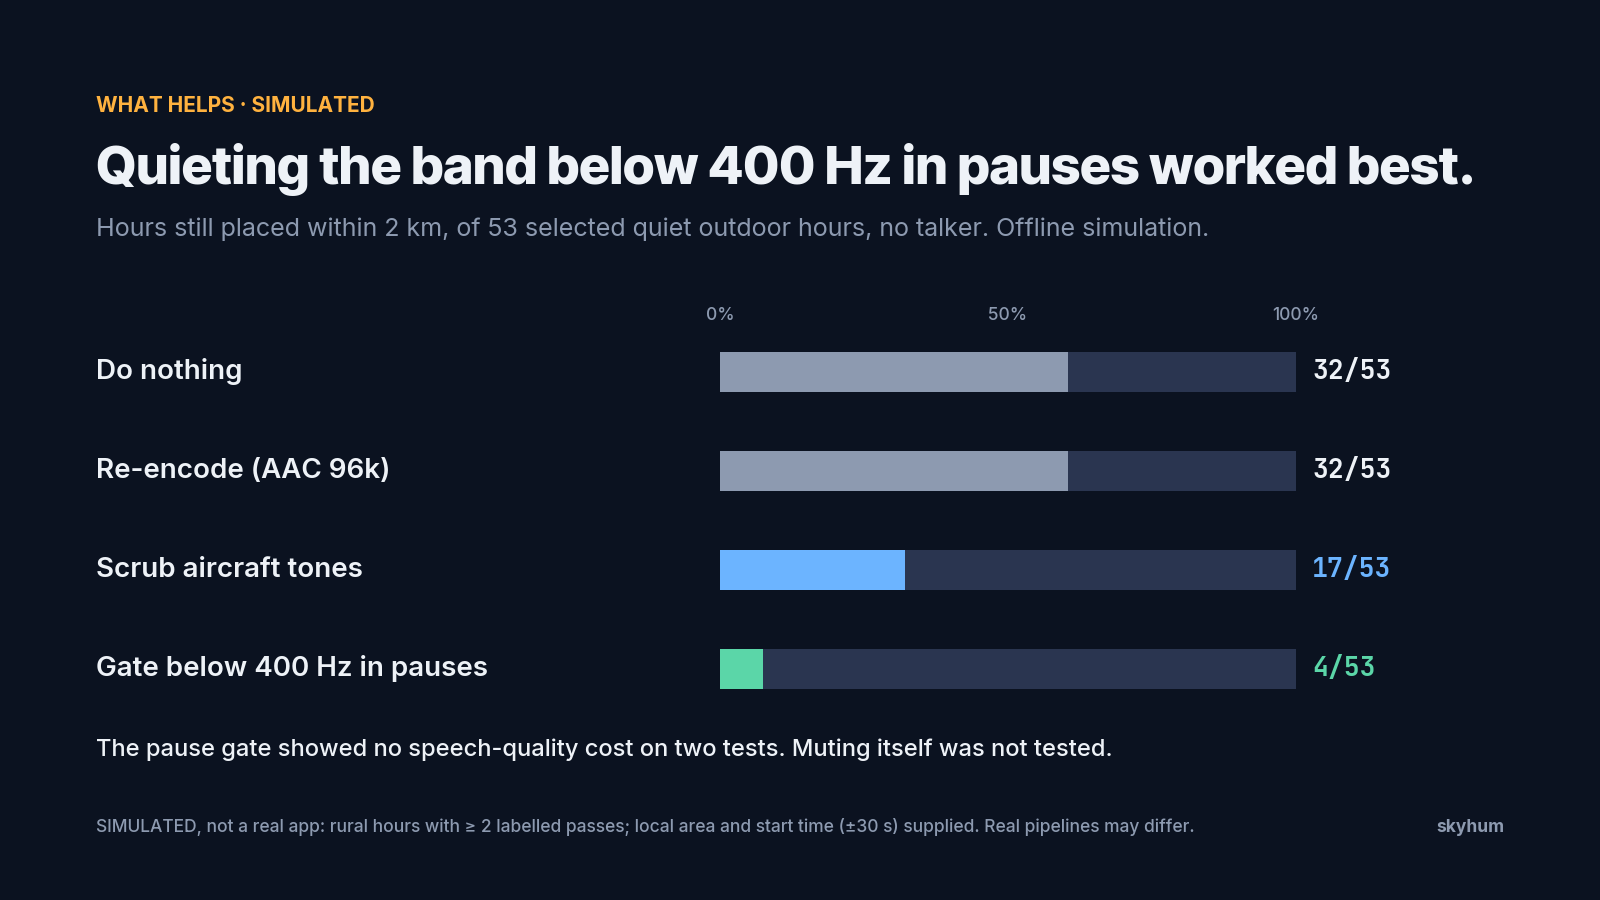 模拟的缓解措施:53 个选定的安静户外小时中仍被定位到 2 km 以内的小时数,没有说话人。什么都不做 32/53,重新编码(AAC 96k)32/53,擦除飞机音调 17/53,在停顿期间对 400 Hz 以下的频段做门控 4/53。离线模拟,不是真实的应用。
**我们只测试了美国和澳大利亚。**我们没有测量过在其他地方公开的飞行历史对小型螺旋桨飞机和直升机的覆盖情况,所以我们对其他国家不作任何断言。
我们是怎么测试的,这些数字涵盖什么
**来源。**我们使用了位置已知的公开录音,来自美国户外摄像头、活动和讲话直播,以及澳大利亚乡村声学传感器。全国范围的搜索从未拿到过站点坐标。我们把已知站点用于评分、部分时钟校准、知情的飞越标注,以及下面描述的局部范围测试和借助真实位置的测试。没有任何录音来自真实进行中的会议。
**时钟。**全国范围的搜索假设开始时间已知,误差在五秒以内。有些时钟是在已知站点上校准的。缓解措施的模拟使用了 ±30 s。局部范围的置信度测试使用了每段录音自己的元数据时钟,对大多数上传的录音来说它更宽松。
通话。我们把音频以数字方式送入桌面客户端。四个通话测试站点偏向于能听到飞机的情况。在它们的 16 个小时中,有 9 个至少有两次标注过的飞越,而全部 110 个摄像头小时中只有 11 个。对于普通的室内或手机通话者,我们没有实测的成功率。我们也没有真实的蜂窝网络或 FaceTime 结果。
近距离飞越的结果以检测到一次真实的近距离飞越为条件,并假定了本地搜索框和站点高度。我们用真实位置来挑选较好的那个镜像点,并且 54 个中 29 个的并集是事后统计的。
模型估算和模拟的结果在正文中都带有这些标注。我们对都会区和具名地点建模时假设每一次可听到的飞越都被检测到。缓解措施是我们模拟的。
**置信度。**在另一项针对 634 段公开录音的局部范围测试中,有 18 个定位结果通过了两项置信度检查。其中 14 个在 2 km 以内,4 个落在这个距离之外。
**界限。**单一答案搜索的成功数量,是我们的实现在这些输入上的下界。更好的工程可以在同样的音频上提高成功数量。误接受率和基线则可能朝任一方向变动。我们从没有直接测试过二选一的城市判断(例如湾区对洛杉矶)。
**致谢。**远处嗡鸣的想法是 colsto 的:I discovered a sound that leaks your exact location。我们从 AlanBacker/audio-flyover-geolocation 起步,这是一个与 colsto 没有关联的独立实现。训练好的模型、真实录音的基准测试和更快的搜索是我们自己加上的。
**数据致谢。**澳大利亚乡村传感器的音频:Australian Acoustic Observatory: A Network to Monitor Biodiversity。Project Team,由澳大利亚政府通过 Australian Research Council 资助(LE170100033)(2018)。Brisbane, QLD: QUT。www.acousticobservatory.org。以 CC BY 4.0 许可发布。我们对数据做了修改:本文中的频谱图、响度曲线和重放的片段都是由它派生的。这些数据不附带任何担保,QUT、各参与机构和 ARC 均不对我们的使用承担责任。航迹:adsb.lol(ODbL)。地图:© OpenStreetMap contributors(ODbL)、Natural Earth、ABS ASGS 2021 SA4(CC BY 4.0)、US Census CBSA 2023。
开源。skyhum 工具、训练好的检测器以及复现这些数字的代码都已开源,地址是 https://github.com/bojieli/skyhum (alpha),公开摄像头各小时的派生特征(不含音频)放在 v0.2.0-alpha release 中。它用于研究和防御,不是用来定位普通个人的。基准测试的元数据只有链接,从不包含音频。