从 265 个开源模型的权重里,读出它们诞生在哪种 GPU 上
🌐 语言:中文 · English
今天,Unemployment Labs 的 Will DePue 发表了 Checkpoint forensics 一文,指出只看一个开源模型的权重文件,就能判断它最初的权重是在哪一类 GPU 上生成的。我没看他的代码,从零把这套方法重新实现了一遍,并在我能下载到的每一个开放权重 LLM 上都跑了一下。结论是:这个方法站得住。下面先讲结果,再讲原理,原理部分是写给从没琢磨过 GPU 随机数生成器的读者的。
TL;DR
- PyTorch 给新模型填随机数时,会用满 GPU 的全部线程,而每代 GPU 的线程数各不相同。训练中从未更新过的那些权重,至今还带着这个线程数。
- 我扫了 265 个开源模型,其中 185 个有读数。这 185 个发布版本只对应 125 次不同的初始化——各家实验室会把同一份权重重复发布,也会拿别家的模型来微调。
- 25 个发布版本读出 Blackwell 级,共 16 次初始化、12 家开发者。线程数对应 GB200/GB300 的有:DeepSeek V4-Pro、Kimi K3、NVIDIA Nemotron-3 Ultra 和 Super、Thinking Machines Inkling、蚂蚁 Ling-3.1-flash、IBM Granite-Switch-4.1。对应 B200/B300 的有:DeepSeek V4-Flash、MiniMax M3、Qwen3.8-Flash-Next、LLaDA-MoE-v2、LG K-EXAONE-2.0、SK Telecom A.X-K2、Trillion Labs Gravity-30B。
- 其余的:128 个 Hopper(H100/H200/H800),27 个 A100,3 个 AMD 加速器,1 个 V100,另有 1 个 Kimi 模型混合了两种线程数。
- 每个读数都标了证据等级:152 个来自未经训练的行,28 个来自训练过的行,4 个来自只剩符号的行,1 个来自同一模型的另一次发布。
- 有 65 个模型,原文和我读出的 GPU 类别相同;另有 9 个,双方都没找到 GPU 指纹。两边没有任何矛盾。我多读出了一个(Qwen3.8-Flash-Next),并解释了一处分歧(Qwen3-235B)。
- 读数就是执行初始化的那台设备的线程数。它确定不了具体是哪款芯片,也说明不了模型在哪里训练、硬件归谁所有。
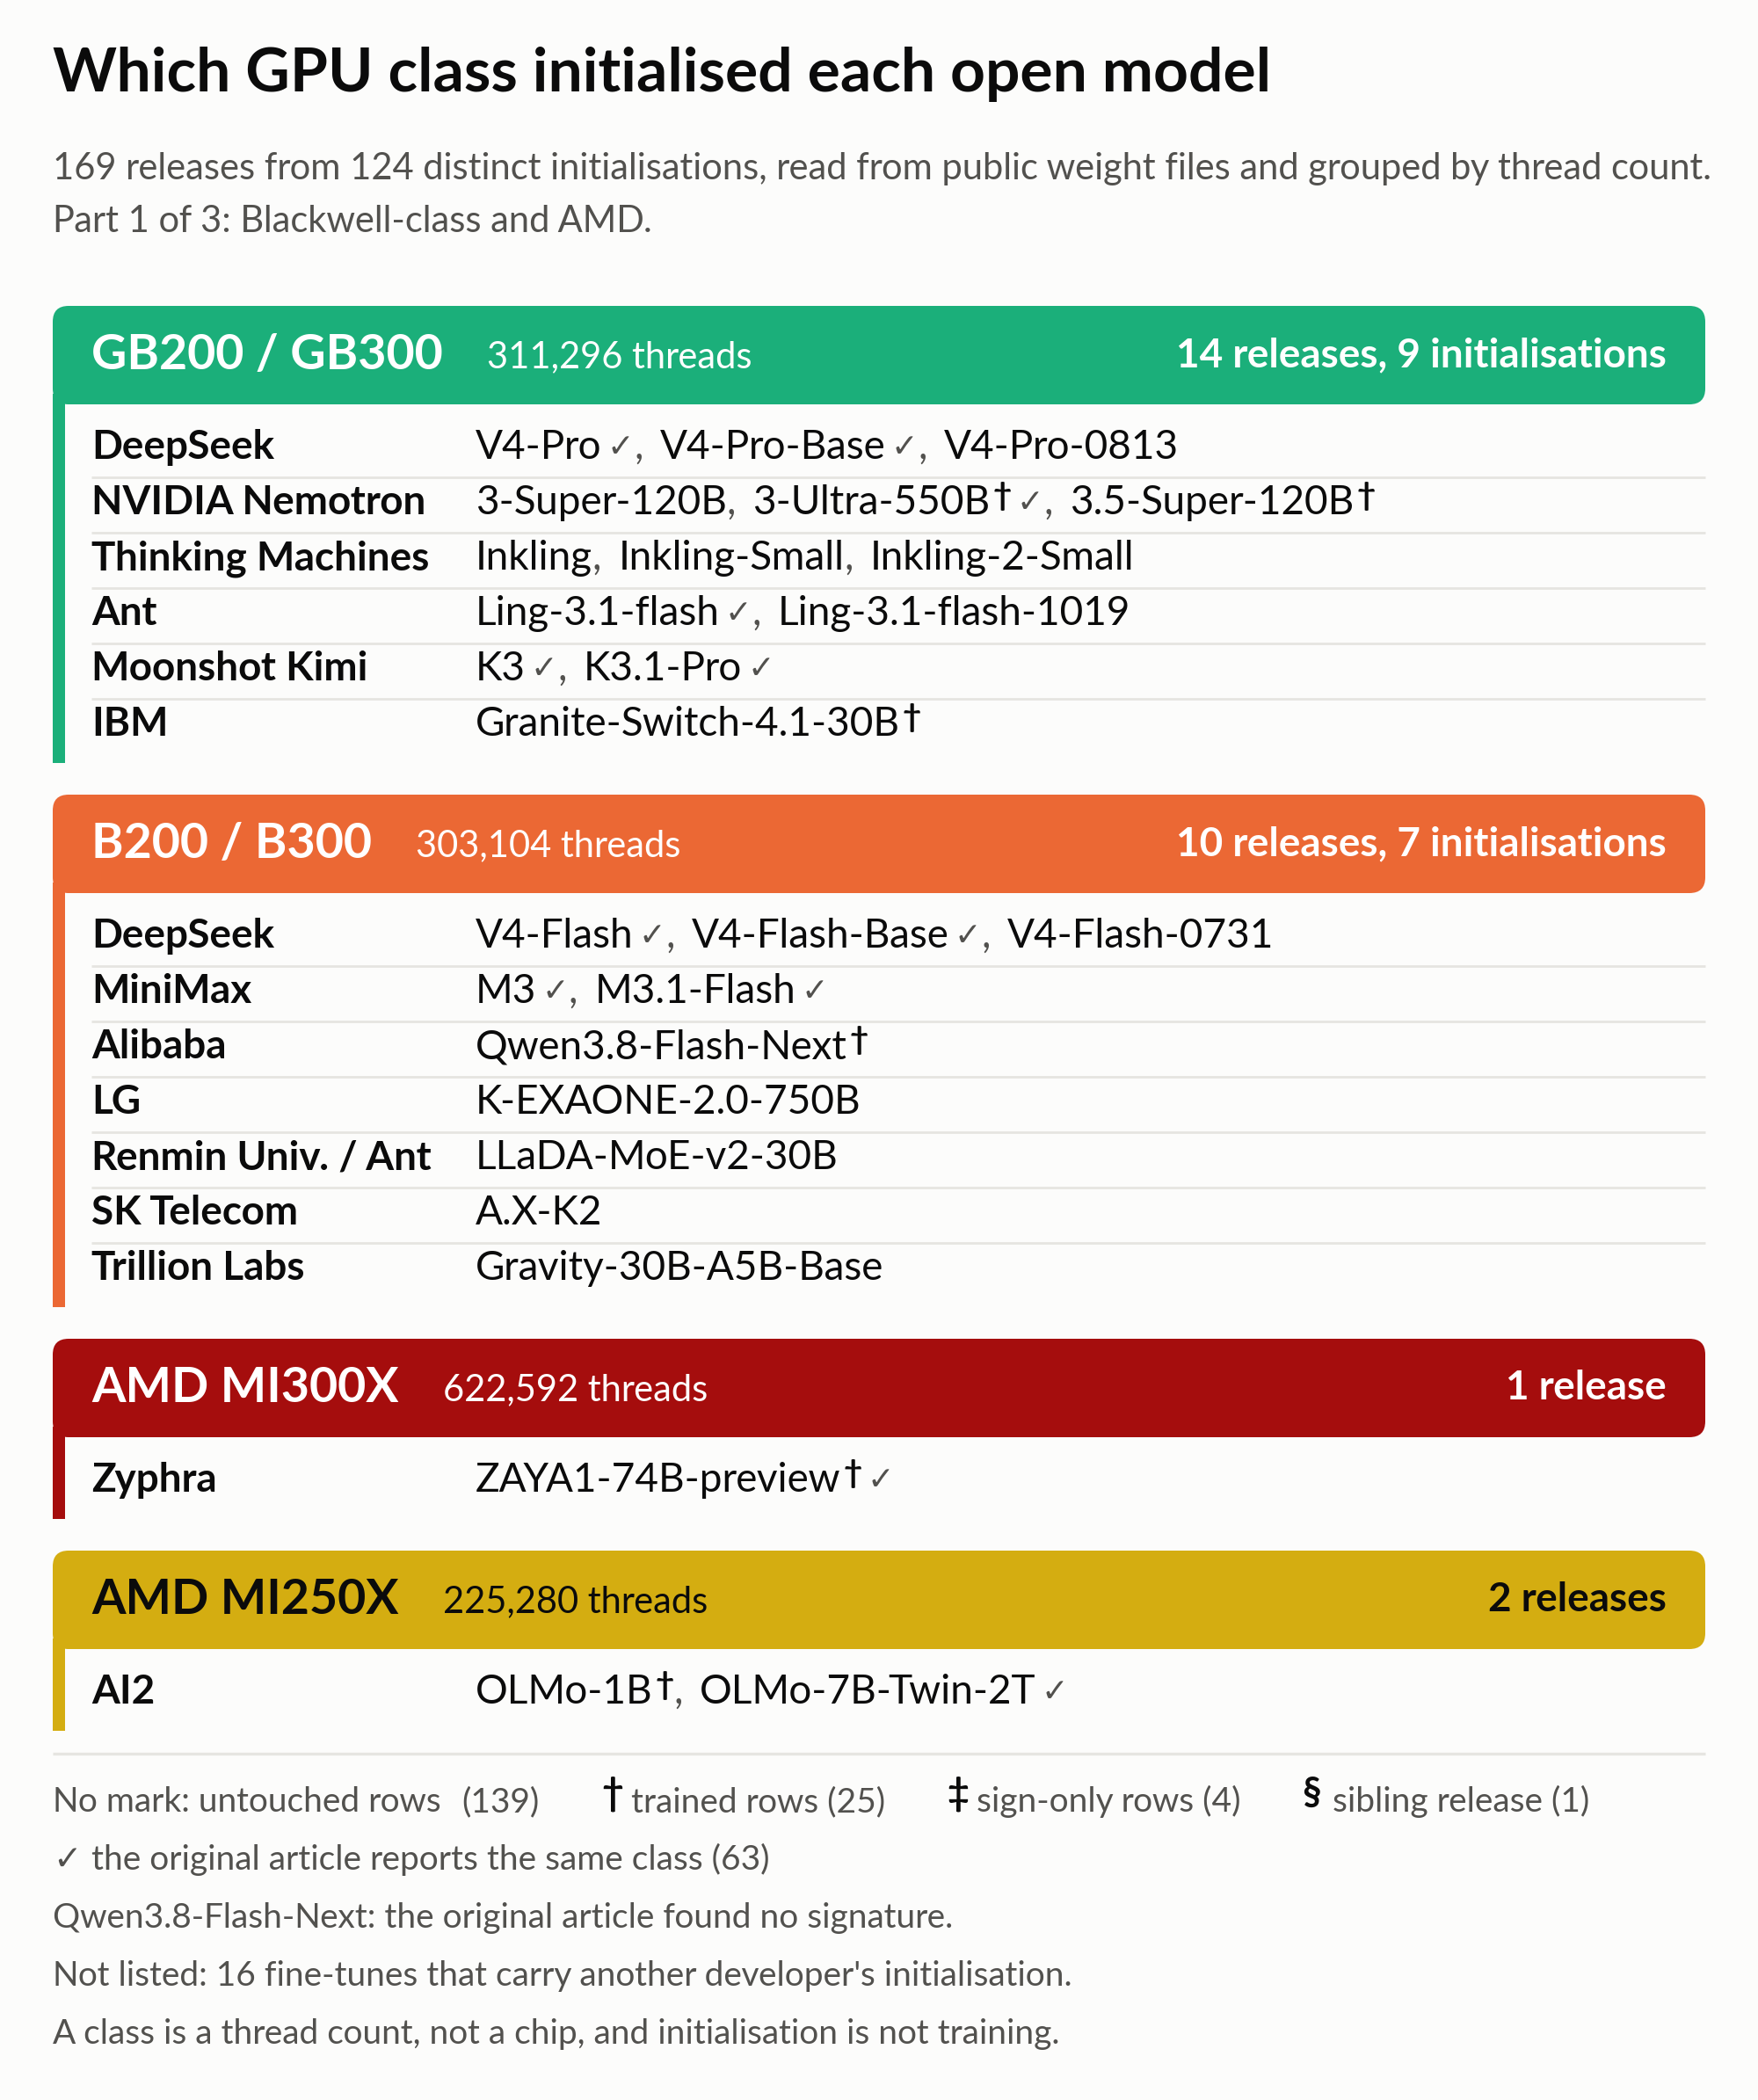 按开发者列出的 Blackwell 级和 AMD 读数
结果
上图汇总了所有 Blackwell 级和 AMD 的读数;另外两张图在后面,分别是 Hopper 和 A100 与 V100。模型名不带标记的,读数来自未经训练的行,这是最强的一档证据:公开的数值就是当初的随机数,我能把它们原样重新生成出来。剑号(†)表示来自训练过的行,双剑号(‡)表示来自只剩符号的行,分节号(§)表示来自同一模型的另一次发布。对勾(✓)表示原文报告了相同的类别。图里只画了 169 个原创的发布版本(124 次初始化);正文的统计则覆盖全部 185 个,也包括在别家模型上微调出来的版本。
Blackwell。 GB200/GB300 有 311,296 个线程,B200/B300 有 303,104 个。
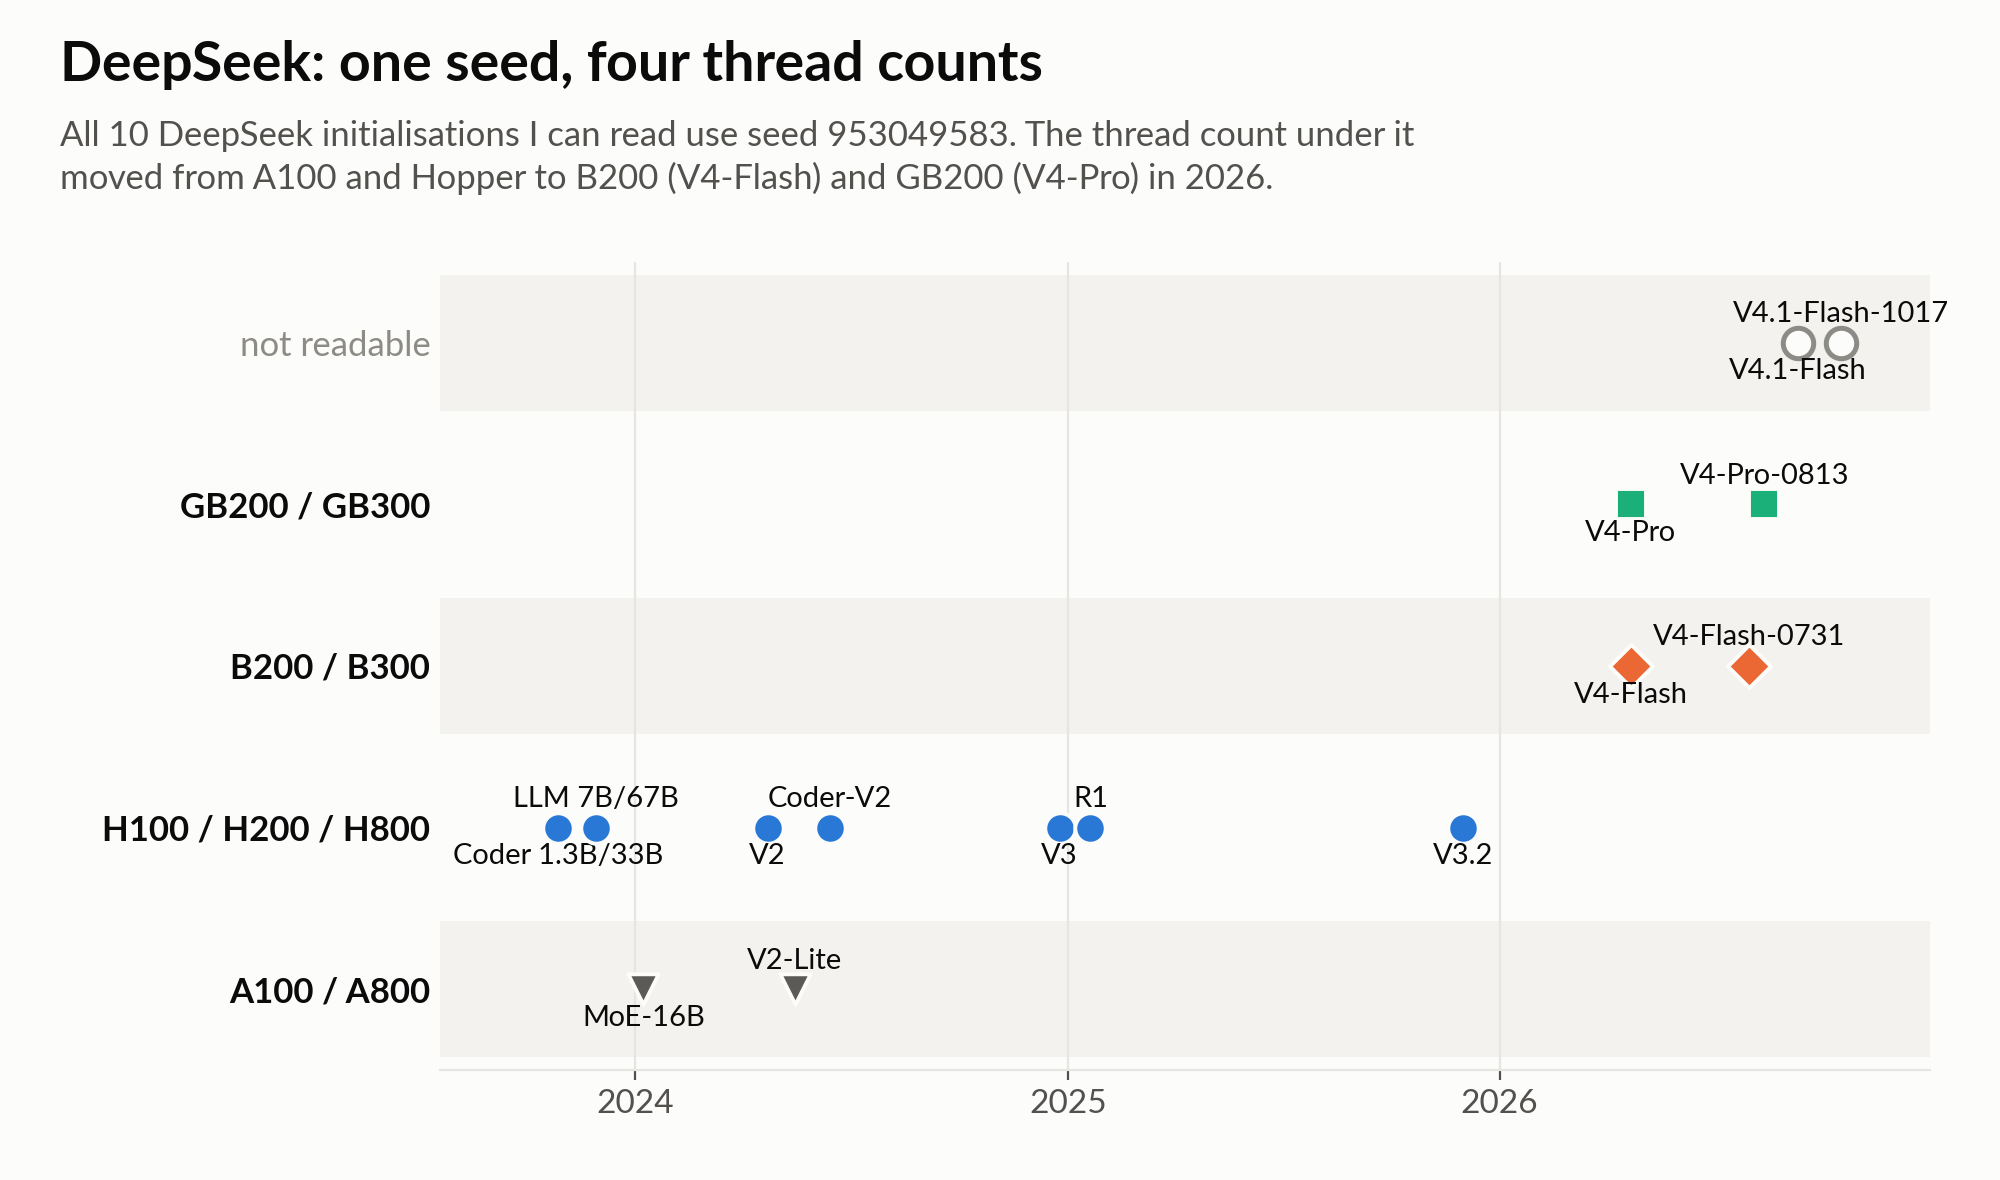
- DeepSeek。 V4-Pro 读出 GB200/GB300,V4-Flash 读出 B200/B300,各自依据大约 460 个未经训练的行。在此之前,凡是我能读出来的 DeepSeek 模型,不是 Hopper 就是 A100。
- 月之暗面。 Kimi K3 和 K3.1-Pro 出自同一次初始化,未经训练的行读出 GB200/GB300。K2 到 K2.6 是 Hopper,K2.7-Code 则是个混合体(见后文)。
- MiniMax。 M3 和 M3.1-Flash 也是同一次初始化,未经训练的行读出 B200/B300。M1 到 M2.7 是 Hopper。
- NVIDIA。 Nemotron-3 Super 依据 862 个未经训练的行读出 GB200/GB300,Nemotron-3 Ultra 和 3.5 Super 依据训练过的行读出同样的结果。NVIDIA 的技术报告写明,Ultra 有一部分训练是在 GB200 上做的,所以这一条算是一次验证,只不过是间接的:训练用的硬件,只能暗示初始化是在什么硬件上跑的。Nemotron-3 Nano 和 3.5 Lightning 是 Hopper。
- Thinking Machines。 三个 Inkling 模型都读出 GB200/GB300,每个都依据大约 1,000 个未经训练的行。
- IBM。 Granite-Switch-4.1-30B 依据训练过的行读出 GB200/GB300。Granite-3.3 是 Hopper。
- 蚂蚁集团。 Ling-3.1-flash 依据 139 个未经训练的行读出 GB200/GB300,和原文一致。Ling-1T、2.6 和 3.0 是 Hopper。
- 阿里巴巴。 Qwen3.8-Flash-Next 依据训练过的行读出 B200/B300,而原文在这里写的是「no signature」(无特征)。输出层的信号很强(365σ,排第二的线程数只有 1σ 左右),embedding 里弱一些(18σ)。Qwen3.5-397B 和 Qwen3.8-2.4T 依据训练过的行和输出层读出 Hopper。
- 中国人民大学和蚂蚁。 LLaDA-MoE-v2 依据 367 个未经训练的行读出 B200/B300。它和 Ling 用的是同一套训练栈。
- LG、SK Telecom 和 Trillion Labs。 三个韩国模型——K-EXAONE-2.0、A.X-K2 和 Gravity-30B——都从未经训练的行读出 B200/B300。Gravity 只有词表最前面那部分行能读;最后那些行后来又被别的什么东西填过,具体是什么我还没弄清楚。LG 的 EXAONE-4.5 和 SK Telecom 的 A.X-K1 是 Hopper。
有几点限制,对中国的实验室尤其要紧:线程数不等于芯片,初始化不等于训练;这里的任何结果,都说明不了硬件归谁所有、放在哪里,也说明不了有没有人违反了什么规定。
DeepSeek 是最干净的例子:种子一直没变,变的只是种子底下的线程数。
 DeepSeek 历代模型的 GPU 类别
AMD。 有三个模型读出的是 AMD 加速器。Zyphra 的 ZAYA1-74B 依据训练过的行读出 622,592 个线程,正好是一整块 MI300X,而 Zyphra 自己说过这个模型是在 MI300X 上训练的。AI2 的 OLMo-7B-Twin-2T 依据未经训练的行读出 225,280,相当于半块 MI250X;LUMI 超算用的就是这款芯片,而 AI2 正是在 LUMI 上训练的这个模型。OLMo-1B 依据训练过的行读出同样的线程数。我没写任何针对 AMD 的代码,用的还是模拟 NVIDIA 路径的那个模拟器,照样复现出了这些权重;可见 PyTorch 在 AMD 上排布随机数的方式和 NVIDIA 一样。
Hopper 和 A100。 大多数模型读出 Hopper:128 个发布版本,82 次初始化。其中有 Meta 从 Llama-3 到 Llama-4 的模型,Mistral 从 Mistral-7B 到 Mistral-Small-4,AI2 后期的 OLMo,阶跃星辰(StepFun),Upstage 的 Solar,Jais,以及 Sber 的 GigaChat3.5。Llama-3.1、Mixtral、OLMo-2 和 -3 以及 Step 系列,原文已经读过;Llama-3、3.3 和 4,Mistral 系列的大部分,以及 Solar、Jais 和 GigaChat,是这次新增的。Llama 系列和 DBRX 的官方仓库我读不了,读的是同一份权重的公开镜像。27 个 A100 读数大多是老模型,比如 Pythia、BLOOM、OPT、OLMo-7B、Yi 和最早的几个 Qwen 模型。RedPajama-INCITE-7B 读出 163,840 个线程,也就是 V100;它是在 Summit 上训练的,而 Summit 正是用 V100 搭起来的。
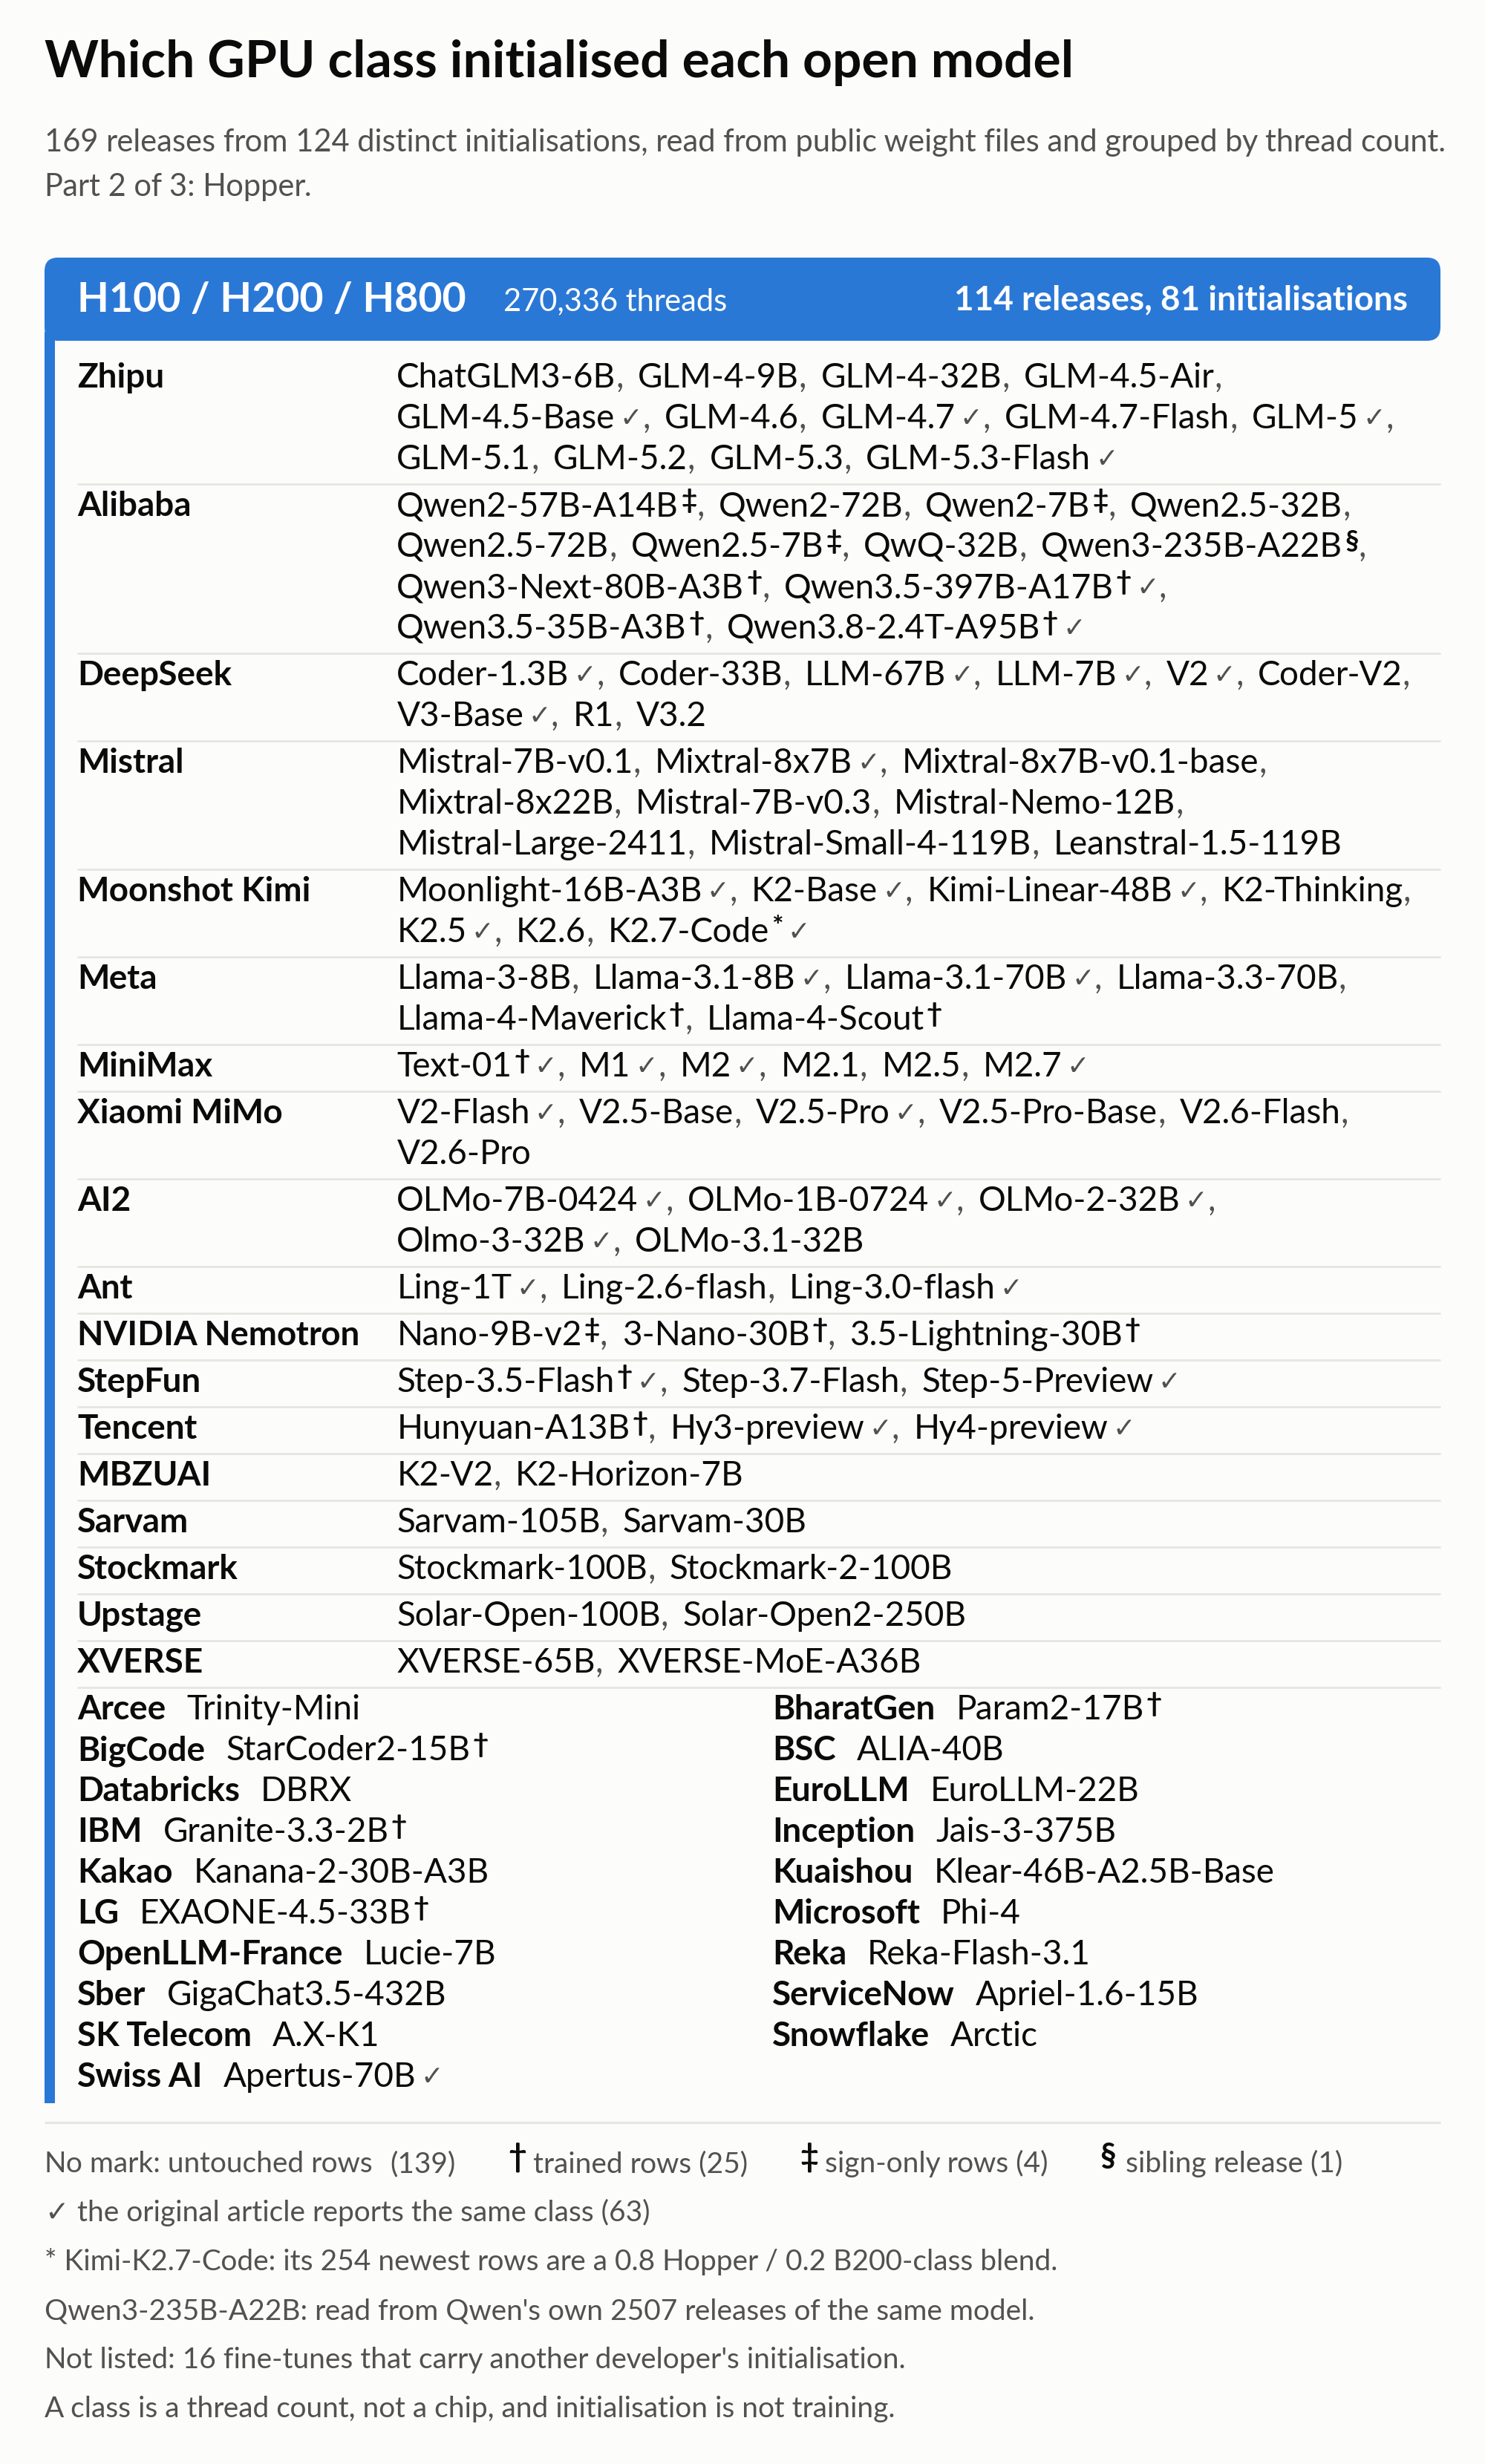 按开发者列出的 Hopper 读数
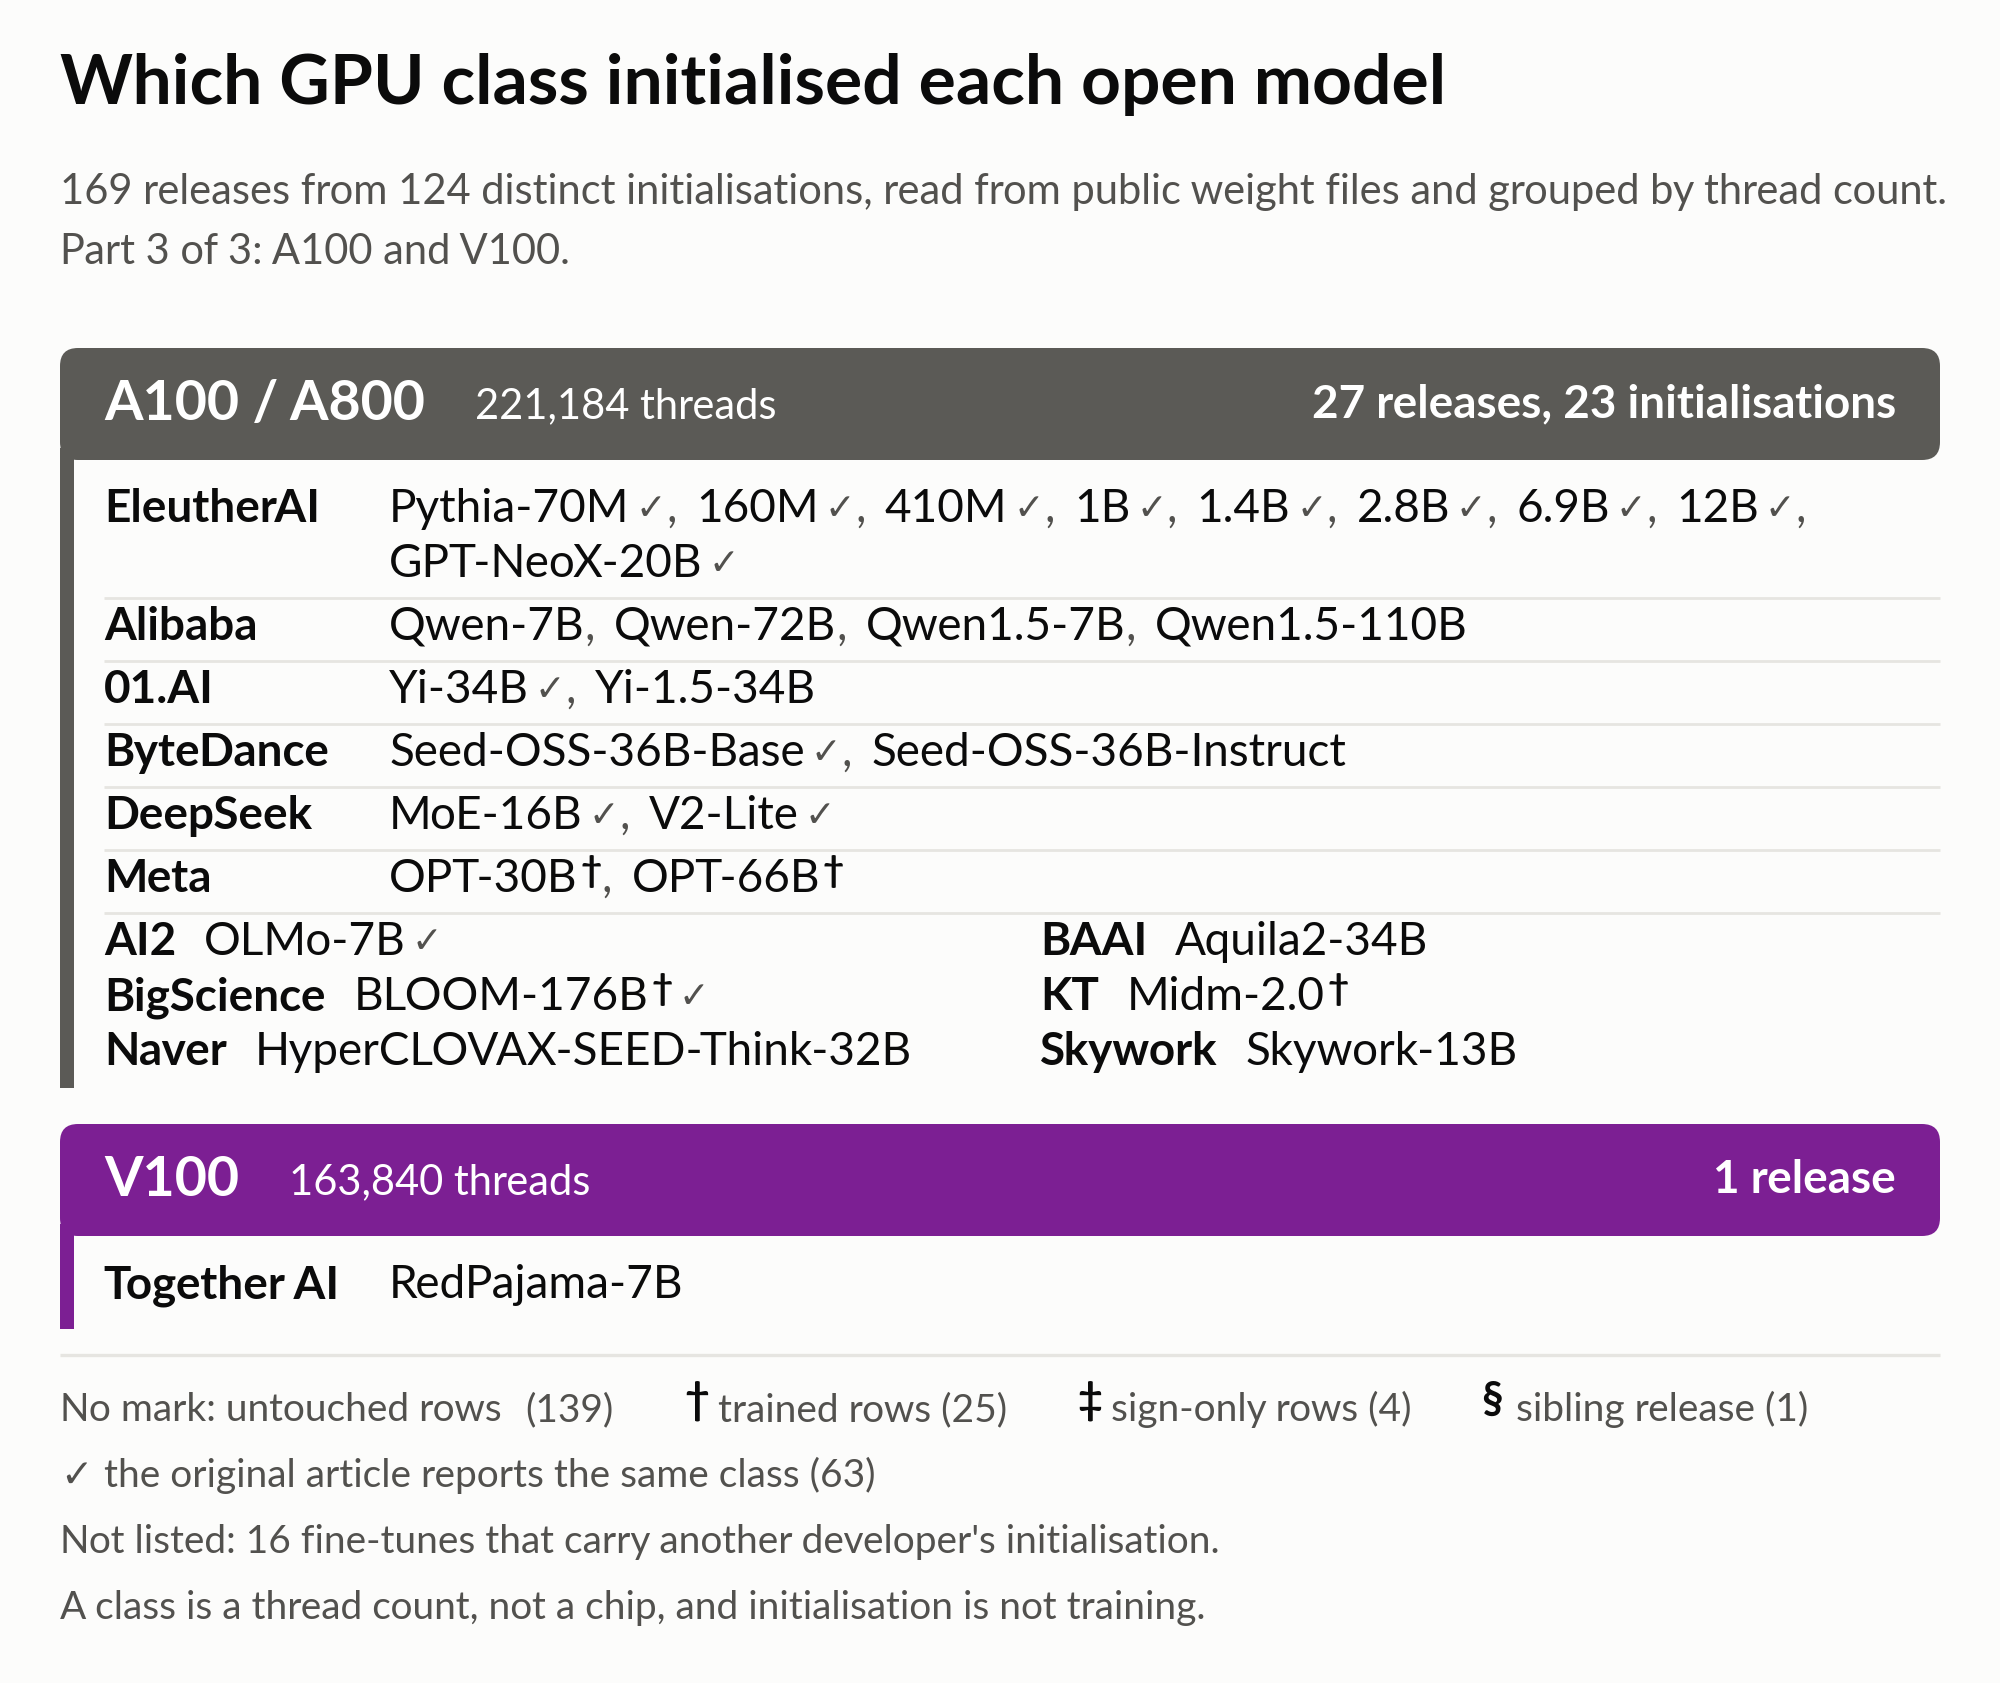 按开发者列出的 A100 和 V100 读数
按上传日期看,转向 Blackwell 级线程数是从 2026 年开始的。
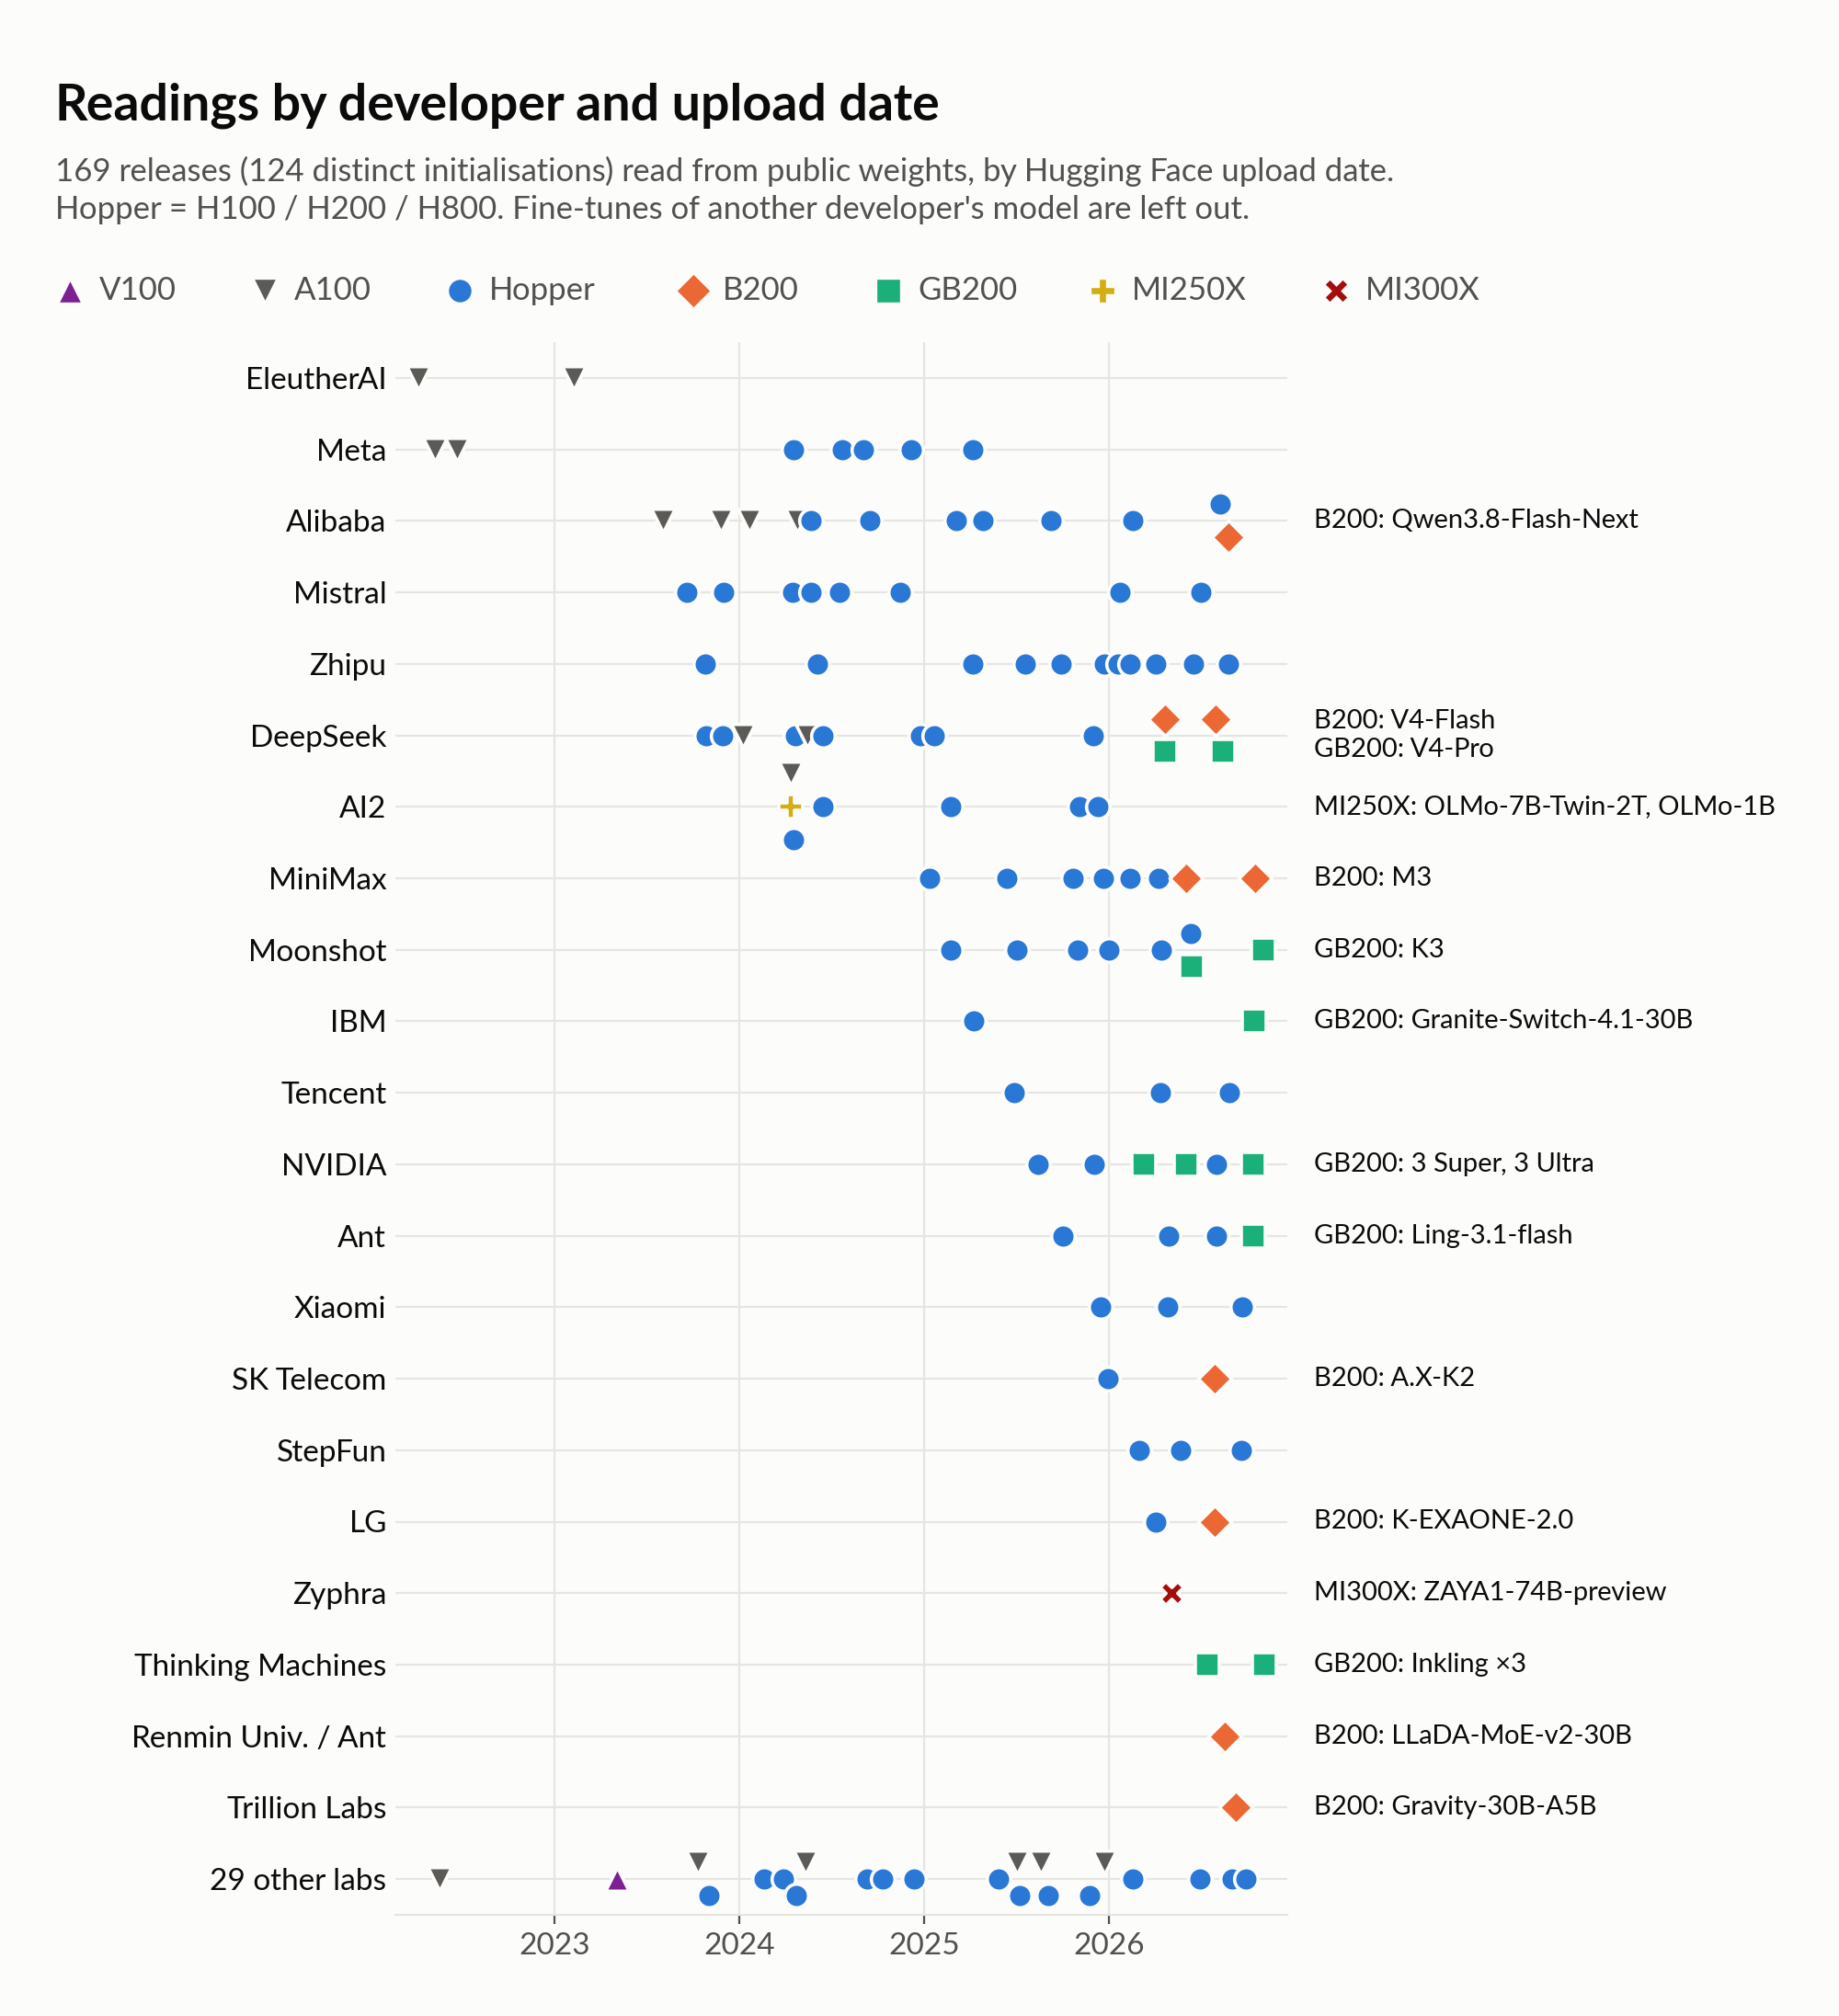 按开发者和上传日期排列的读数
种子。 同一套搜索还能找出随机种子,而种子居然能指认出用的是哪套训练代码。
- 3952 出现在 60 次初始化里(能归到原始开发者的初始化一共 124 次),横跨 28 家开发者,从 2022 年的 GPT-NeoX-20B 一直到 2026 年的 K-EXAONE 和 Nemotron。它等于 1234 + 2718:前者是 NVIDIA Megatron-LM 框架的默认种子,后者是 Megatron 自己额外加上的常数。
- 2760(42 + 2718)、6125(3407 + 2718)和 2718(0 + 2718)走的是同一条代码路径,只是基础种子不同。3407 是个很流行的种子,但带 6125 的 7 次初始化全是 Qwen,从 Qwen-7B 到 Qwen3-235B。种子 2718 是 Meta 的,Llama-3 和 Llama-4 都用它;Meta 的 OPT 用的是 2719。
- 953049583 出现在 2023 年以来 DeepSeek 的全部 10 次初始化里,横跨四种线程数。Kimi 主要用 20256586,不过 Moonlight 用的是 20233441。AI2 早期的 OLMo 用 6198,后来 OLMo-2-32B 用 12536,Olmo-3 用 0。LG 的 EXAONE-4.0 和 4.5 用 17(K-EXAONE-2.0 用 3952),Upstage 用 1997。
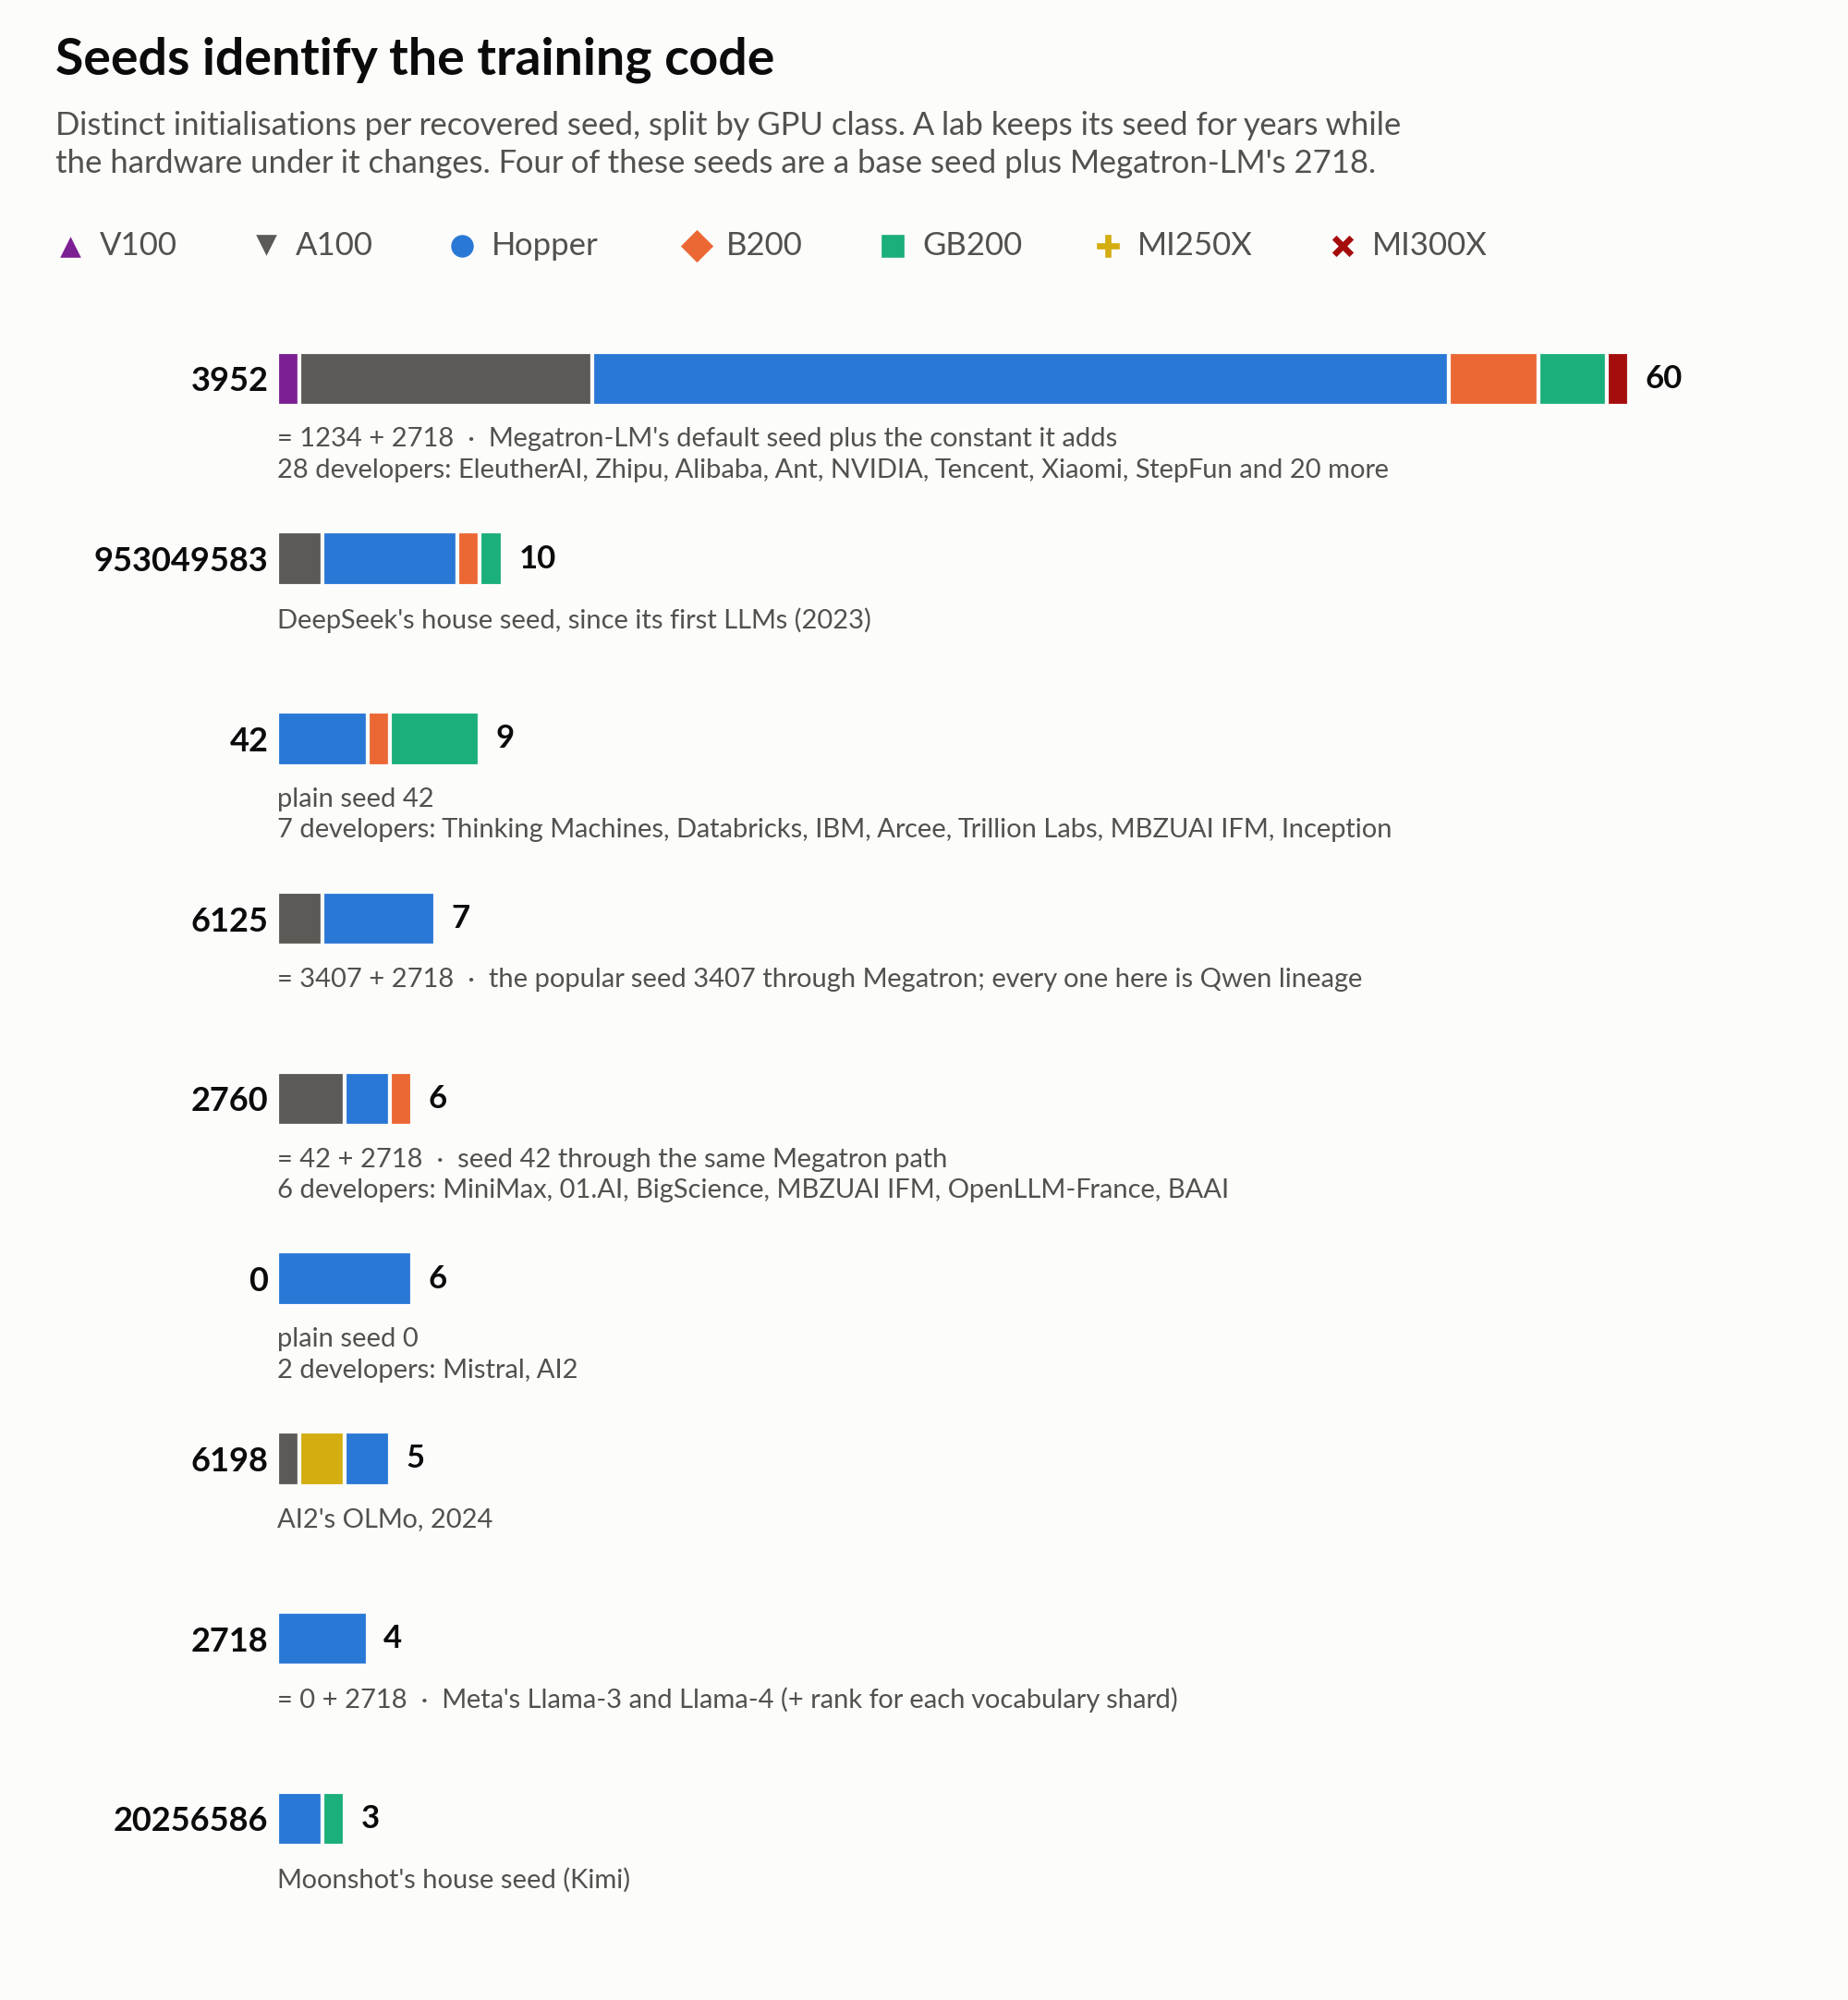 恢复出来的种子,以及有多少次初始化共用它们
微调会继承指纹。 有 16 个模型带着别家模型的初始化。Cogito-671B、RakutenAI-3.0 和 Nex-N1 对上的是 DeepSeek-V3,Nex-N2.5-Max 对上的是 DeepSeek-V4-Pro。INTELLECT-3 对上 GLM-4.5-Air,Atria-Dawn 对上 GLM-5.2。Hermes-3 和 Hermes-4 带着 Llama-3.1-405B 的行,另有三个带着 Llama-3.1-70B 或 3.3-70B 的行。Intern-S2、Baichuan-M3、DeepSeek-R1-Distill-Qwen-32B 和 KAT-Dev-72B 分别对上 Qwen3.5-397B、Qwen3-235B、Qwen2.5-32B 和 Qwen2.5-72B。光凭种子相同,判断不了谁是父模型:两家实验室只要都用 Megatron 的默认种子、tokenizer 又相同,起点就是一模一样的表。所以我改为比较训练过的行:KAT-Dev 的行和 Qwen2.5-72B 的余弦相似度是 0.998,和 Qwen2-72B 是 0.61。后训练不会改动这个指纹,所以 Nex-N2.5-Max 上的 GB200/GB300 读数,属于 DeepSeek-V4-Pro 那次初始化,而不是 Nex 的。
读不出来的。 有 80 个模型没有给出指纹。它们都不能作为硬件方面的证据。
- 25 个模型的行里根本没有 GPU 排布。十个 Gemma 模型、Grok-1 和 GPT-J 出自 JAX,JAX 的随机数与设备无关;GPT-J 那 143 个没用到的行,拿公开的训练代码在 CPU 上就能重新生成。ERNIE-5.5 用的是 PaddlePaddle 的一个旧函数,同样与设备无关。TeleChat2.5 和 TeleChat3 据各自的 model card 所说,是在华为昇腾芯片上训练的。两个 Jamba 模型和 AliceAI 是在 CPU 上初始化的。七个 Qwen 模型(Qwen3-8B、14B、30B 和 32B,Qwen3.5-9B 和 27B,Qwen3.8-27B)没用到的行在训练之后被 CPU 覆盖过,真正的初始化已经无从知晓(见「CPU 写的行」)。
- 11 个模型没有我能用的行。
- 44 个模型有看起来未经训练的行,但我搜过的种子都没法把它们重新生成出来。gpt-oss-120b 是一例:它有 922 个没用到的输出行,全是干干净净的高斯噪声,和 gpt-oss-20b 里的一模一样,却什么都对不上。DeepSeek-V4.1-Flash 是另一例:428 个未经训练的行,既对不上 DeepSeek 惯用的种子,也对不上我试过的其他任何种子;原文在这里同样一无所获。Llama-1、Llama-2、Phi-3 和最新的几个 Mistral 模型也在这一组。ERNIE-4.5 也是:它用的是 Paddle 普通的、依赖设备的 GPU 填充,只要有人找到它的种子,应该就能读出来。
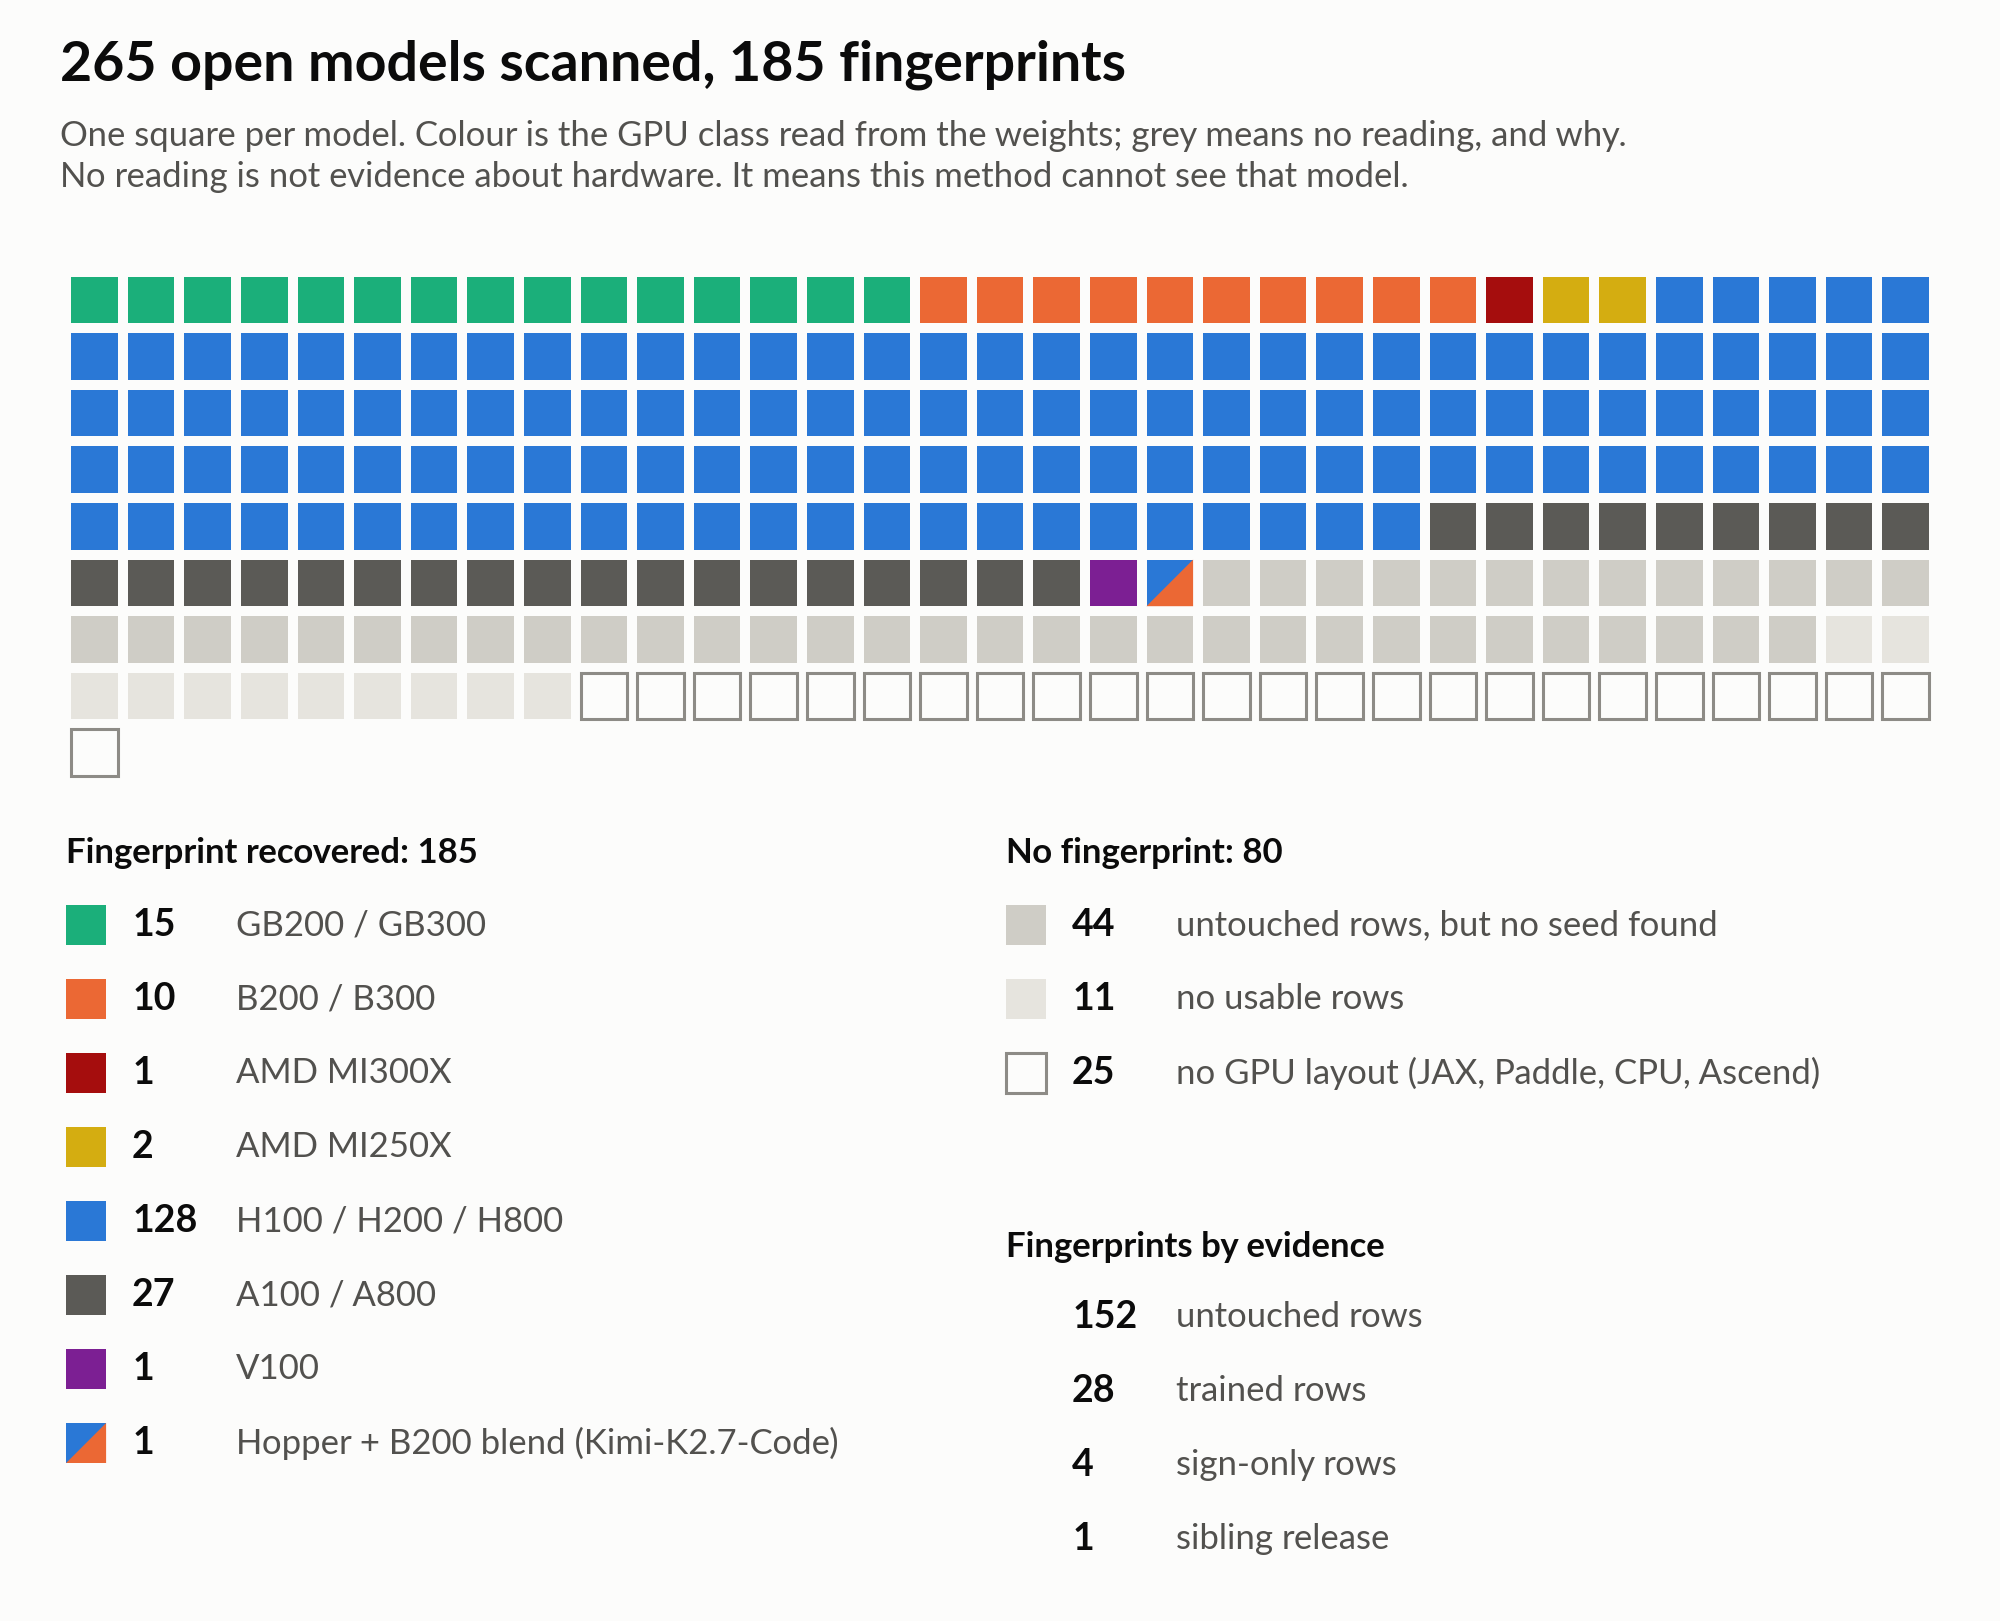 265 个模型:各类别的指纹数量,以及其余模型为什么没有指纹
与原文对照。 有 65 个模型,双方报告的 GPU 类别相同;另有 9 个,双方都没找到 GPU 指纹。DeepSeek-V4-Flash,我得到的是 468 行中 461 行吻合、1,384σ,原文是 469 行中 461 行、1,385σ。Qwen3.8-Flash-Next 是我这边多出来的。Qwen3-235B,原文报告的是 CPU 初始化,我报告的是 Hopper(§);就各自看的那份权重而言,两边都没错。4 月上传的那一版,没用到的行在训练之后被 CPU 噪声覆盖了;而 Qwen 的 2507 版发布的是同一个模型,却保留了原始的行——Instruct-2507 里有 441 行、Thinking-2507 里有 415 行,都能在 Hopper 的线程数下重新生成。Qwen3-32B 和 Qwen3.5-9B 属于那 9 个,情况相同,只是没有留下别的副本。原文对这两个模型报告的是 CPU,我找到的也是同样的 CPU 行,只是我的解读是:它们在训练后被覆盖过。
原理
如果你已经知道 PyTorch 怎么给 CUDA 生成器设种子,可以直接跳到「线程按条纹写入」。
模型的权重一开始都是随机数。这里要看的是 embedding 表:词表里每个 token 占一行。DeepSeek-V4-Flash 有 129,280 行,每行 4,096 个数,每个数都从一条以零为中心、标准差 0.006 的钟形曲线里抽出来。
这些数出自一个生成器,也就是一套固定的配方:给它一个起始数字(种子),它就吐出一长串序列。种子相同,序列永远相同。所以只要猜中种子和配方,我就能把一个模型的初始权重原样造出来。
大多数生成器是链式的,每个数都由上一个数算出来。PyTorch 在 GPU 上用的 Philox 则是基于计数器的:把种子和位置交给一个公式,它直接返回那个位置上的数。这样,许多线程可以同时从同一个种子取数,各管一段位置。验证一个猜测也很便宜,只要算出想比对的那几个位置就行。
每种 GPU 的线程数是固定的
NVIDIA 的 GPU 由一个个流式多处理器(streaming multiprocessor,SM)组成,每个 SM 承载固定数量的线程。GPU 的总线程数,就是 SM 数 × 每个 SM 的线程数。
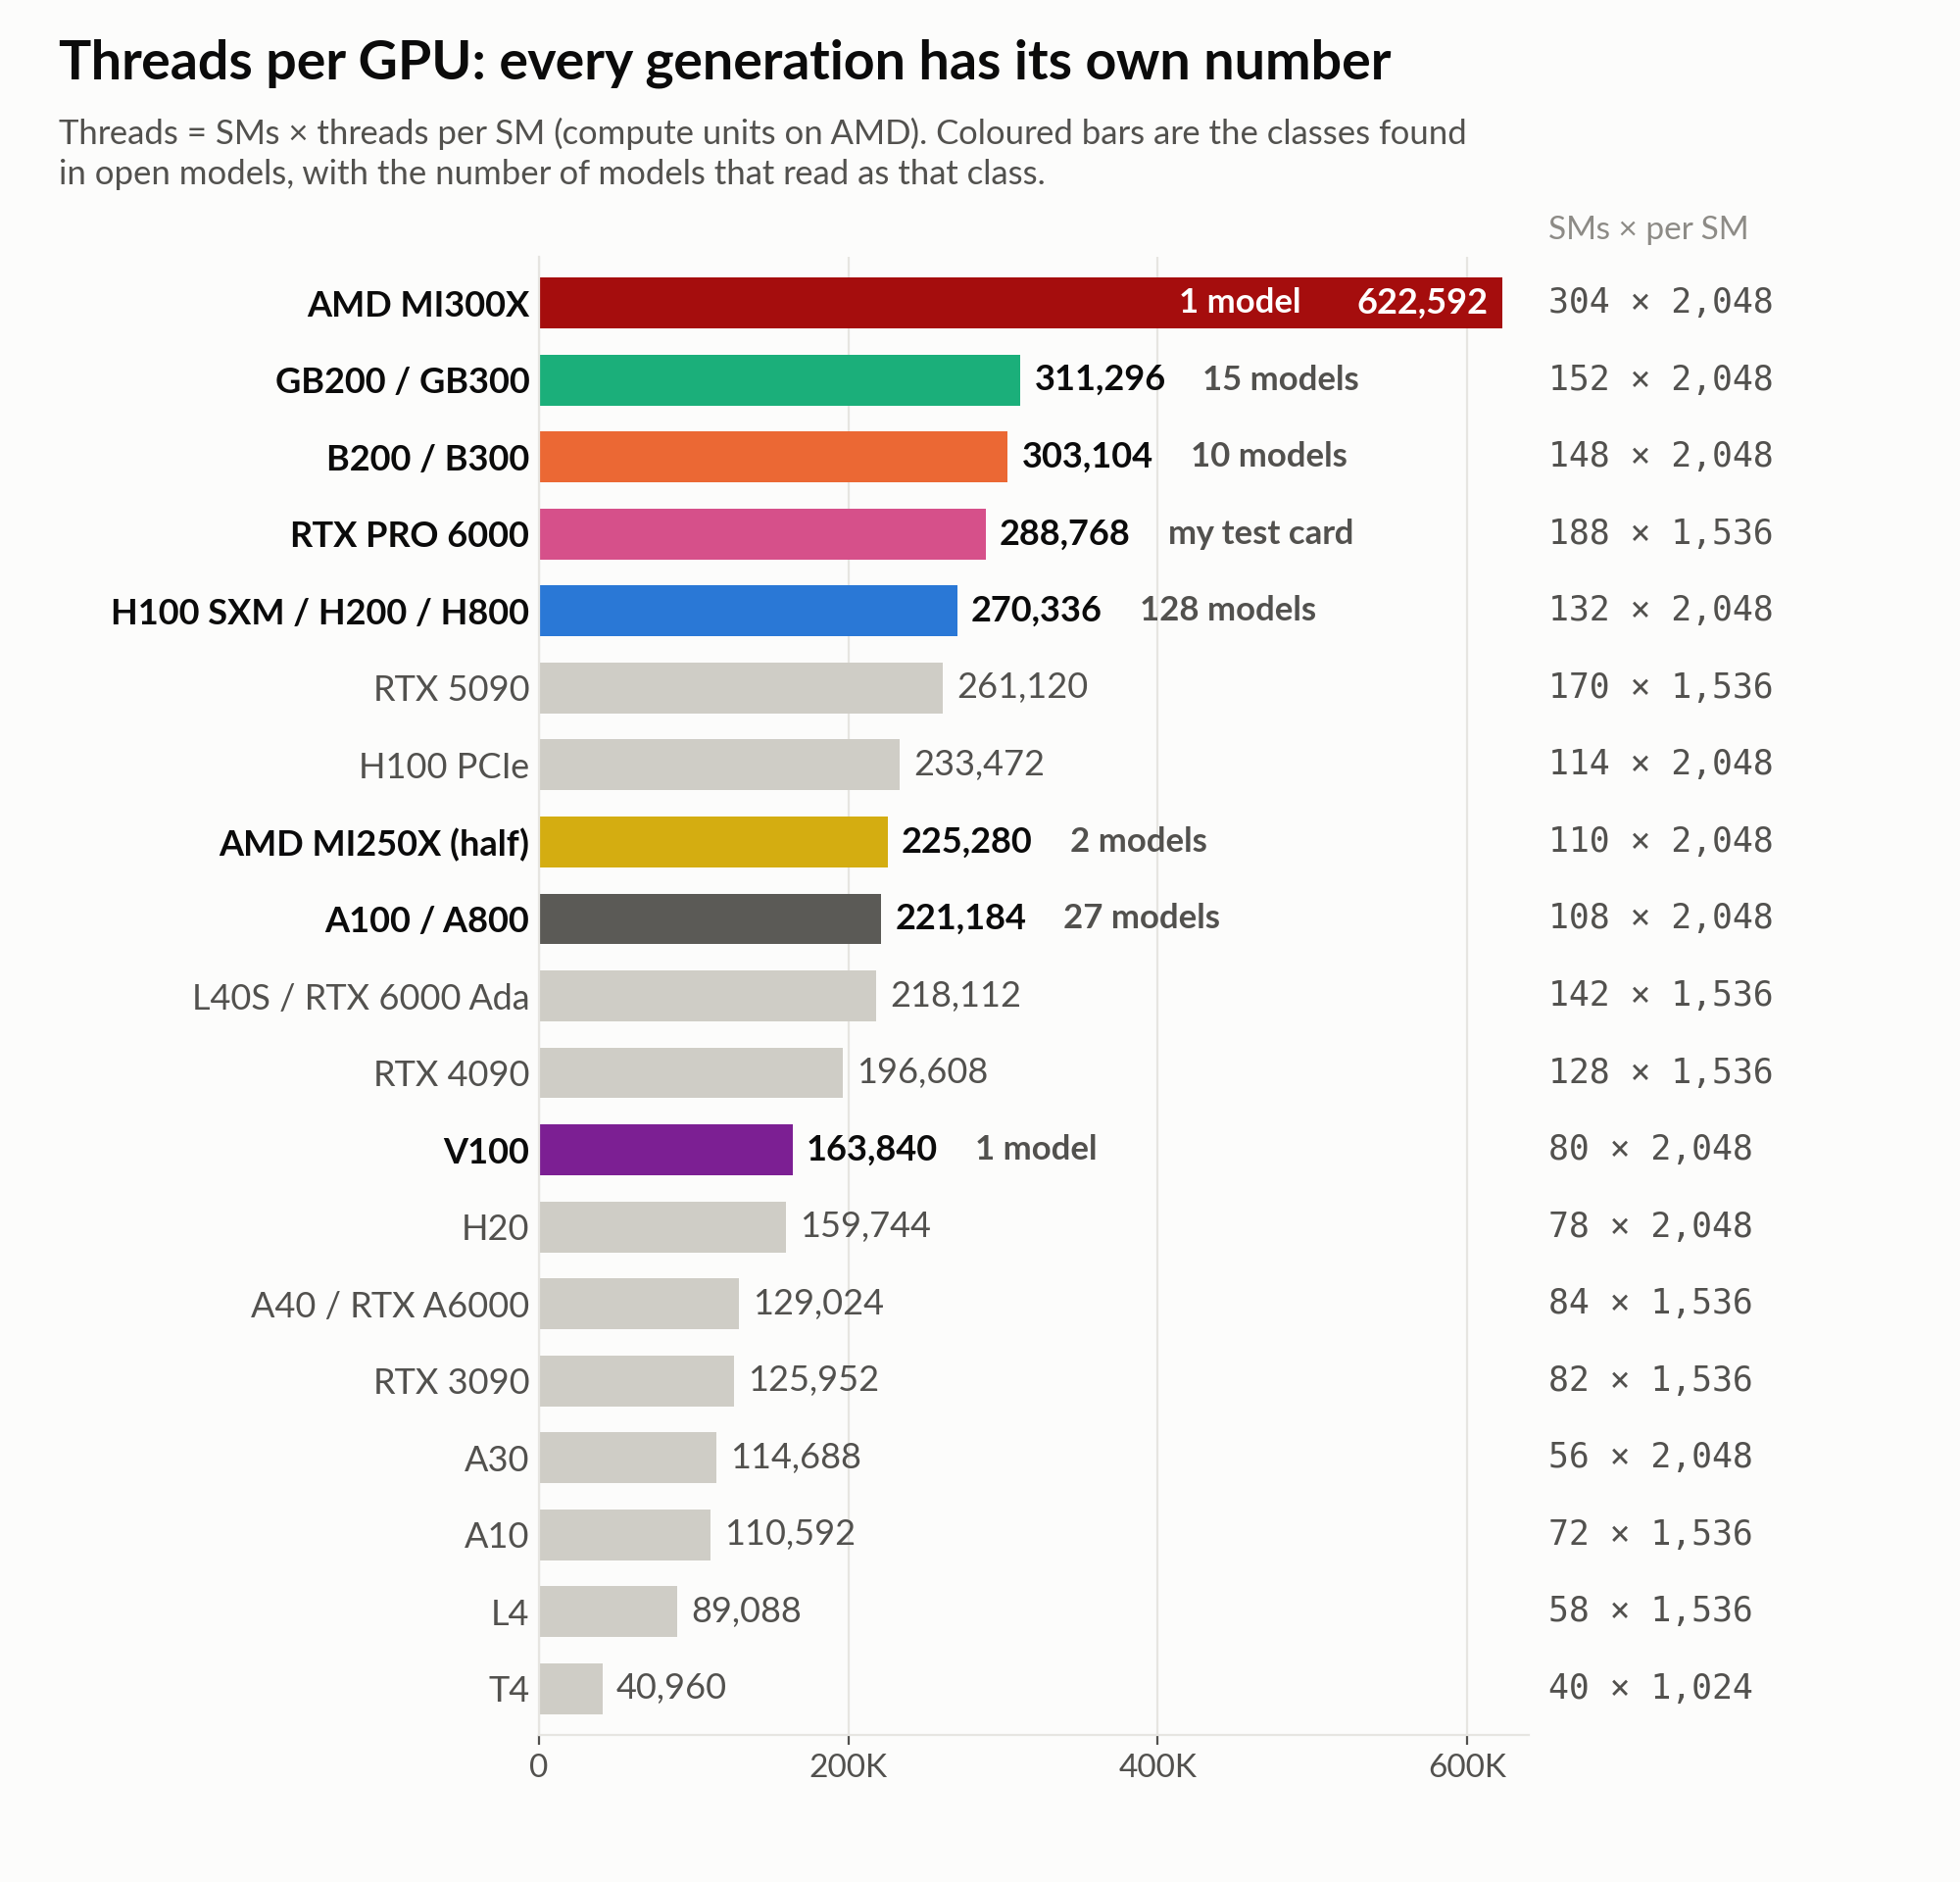 各 GPU 类别的线程数
原文讲的是 SM 数:Hopper 是 132,B200 是 148。不过,A100、Hopper 和 Blackwell 这些数据中心 GPU 每个 SM 有 2,048 个线程,很多别的卡却只有 1,536 或 1,024,所以我直接用总线程数,权重里体现出来的也正是这个数。有些芯片的总线程数相同:H100 SXM、H200 和 H800 SXM 都是 270,336 个线程(PCIe 版的 H100 和 H800 要少一些),B200 和 B300 是 303,104,GB200 和 GB300 是 311,296。同一组里的芯片,这个方法分不开,所以我把每一组叫做一个 GPU 类别。
线程按条纹写入
要给一个大张量填满随机数,PyTorch 会启动 GPU 能容纳的全部线程,把这个数记作 T。线程 0 写第 0、T、2T……个元素,线程 1 写第 1、T+1、2T+1……个元素。每个线程从自己的 Philox 流里取数,这条流由种子和线程编号决定。
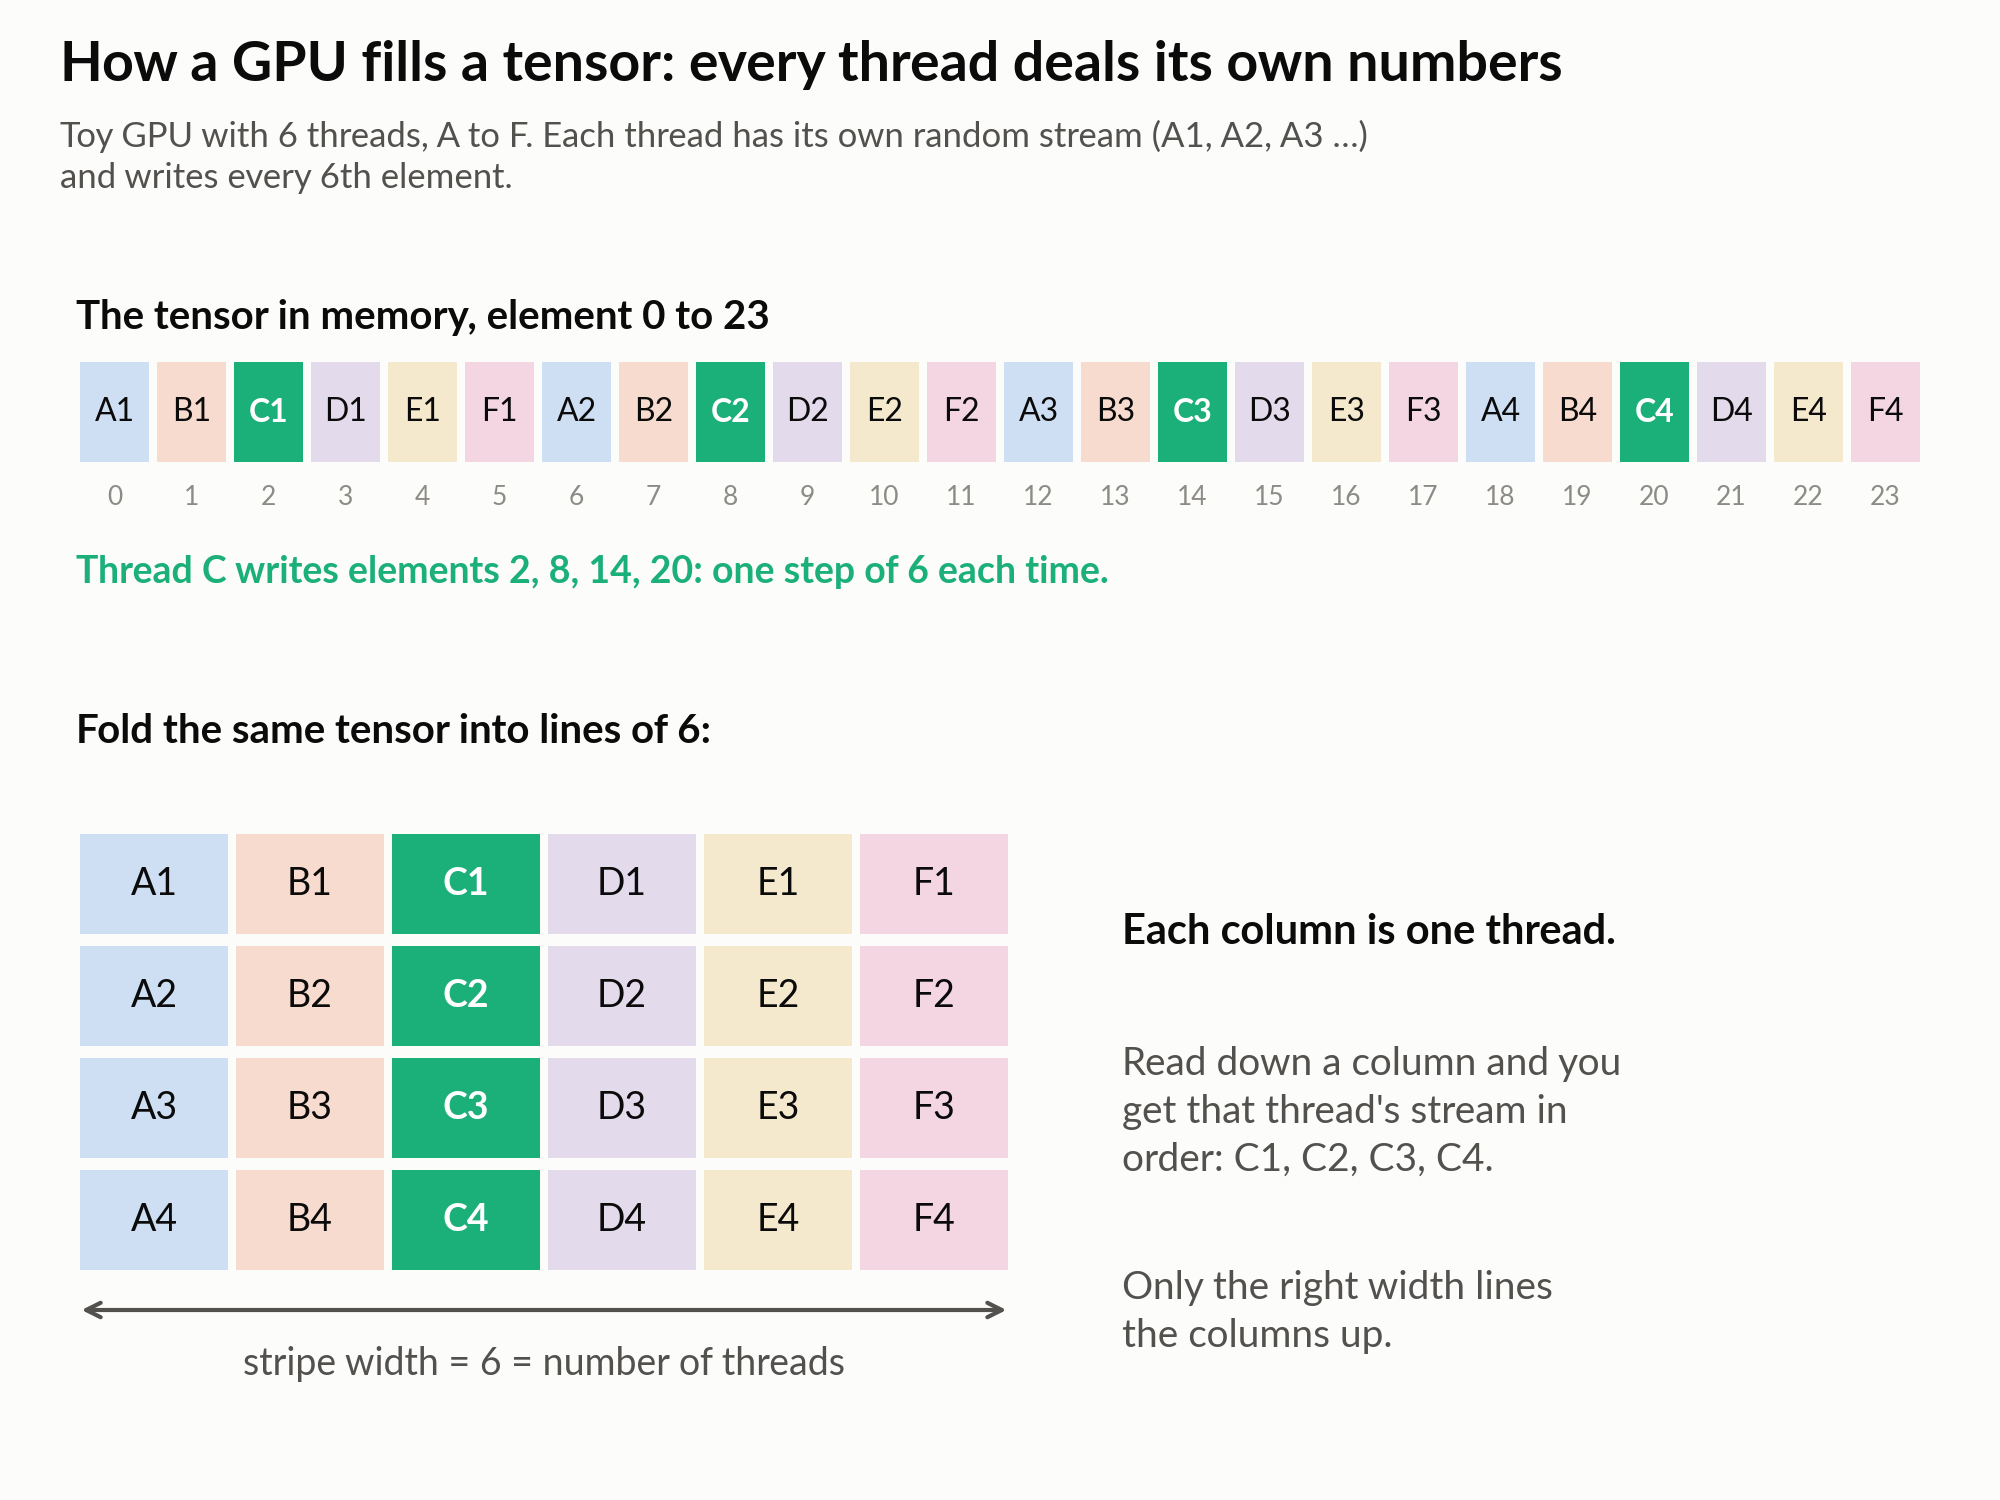 T 个线程轮流填充一个张量
线程 2 不管在哪块 GPU 上,产生的数都一样,但它的第二个数落在位置 T+2:在 H200 上是 270,338,在 B200 上是 303,106。
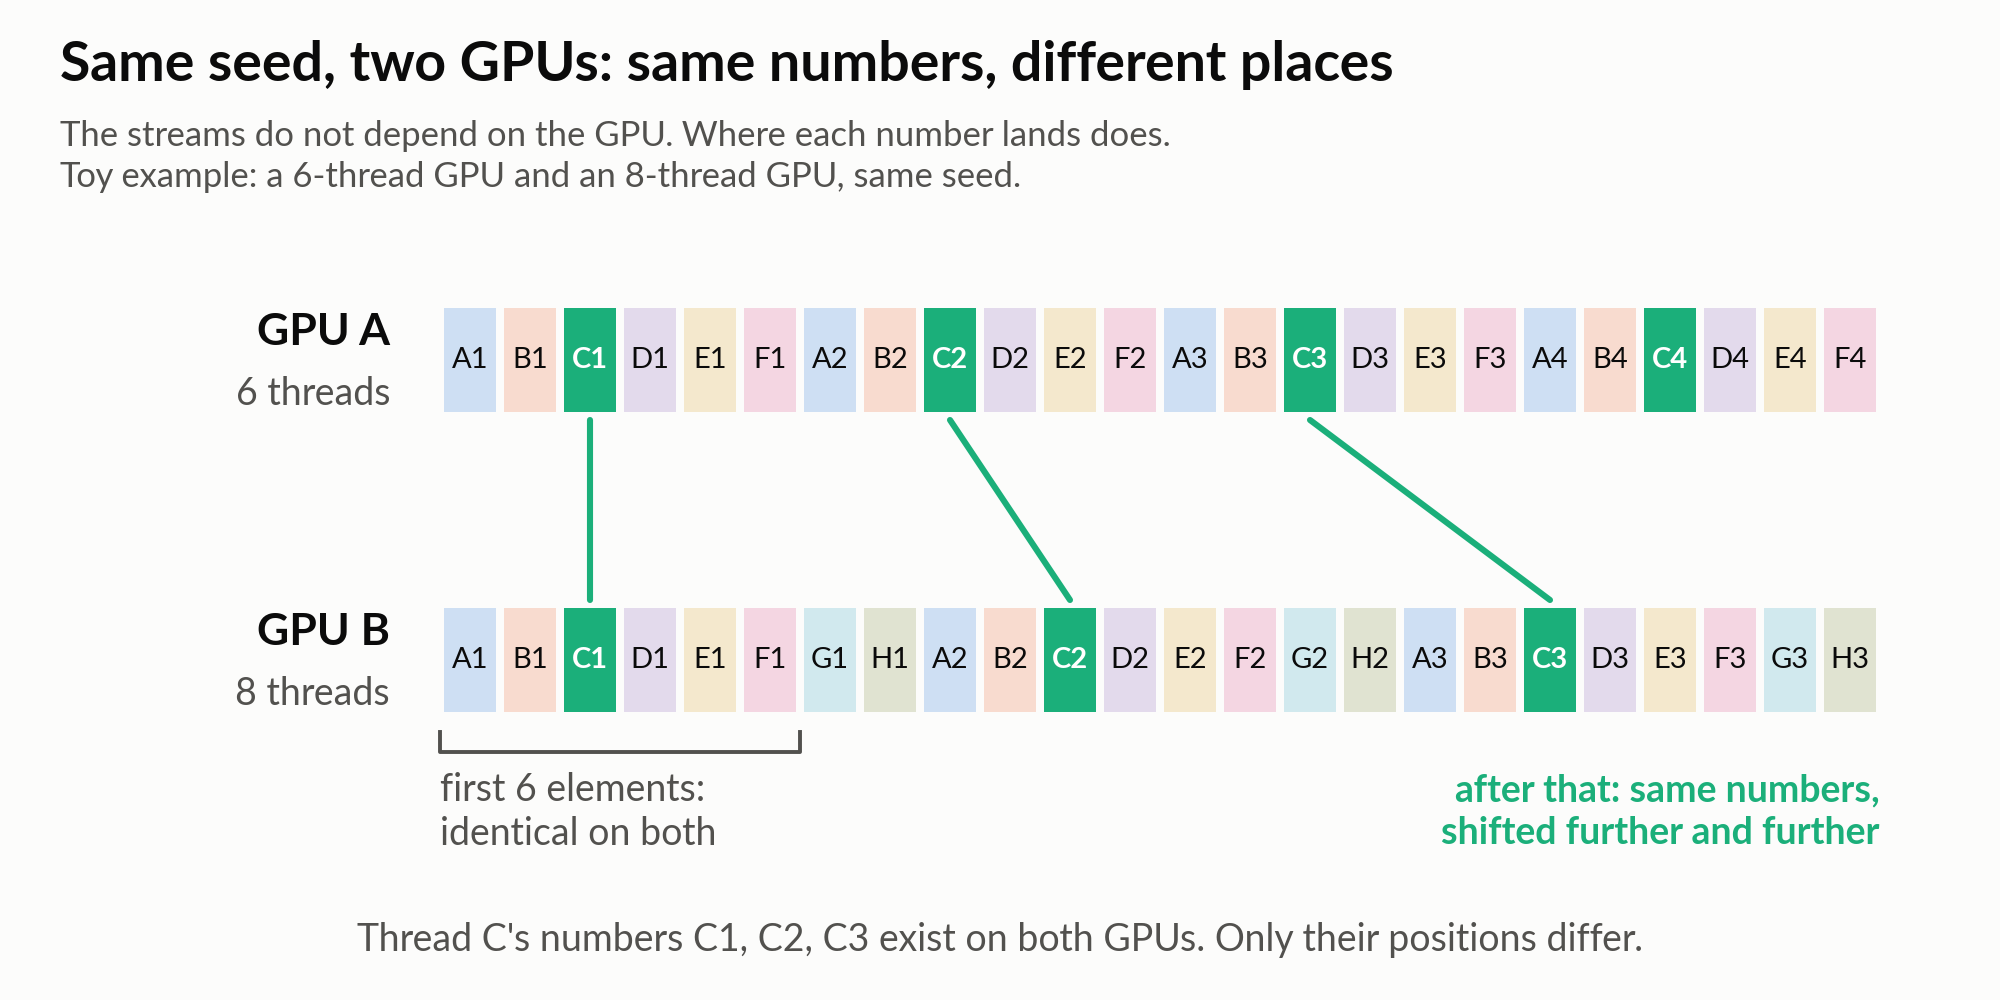 同一个种子在两种线程数下的排布
T 是 PyTorch 从硬件上读出来的,不是谁选的。在 DeepSeek-V4-Flash 的表里,一条条纹(也就是 T 个元素)在 B200 上正好覆盖 74 个 token 行,在 H200 上是 66 行。最前面的 T 个元素在所有 GPU 上都一样,因为每个线程写的都是自己的第一个数;信息藏在后面。
我没有 B200,所以把 PyTorch 的 CUDA 填充重新实现了一遍,把 T 做成参数。在我自己的卡上(RTX PRO 6000,288,768 个线程),模拟器和真实的 PyTorch 逐比特一致。
有些行从没训练过
embedding 的一行,只有对应的 token 在训练文本里出现过,才会拿到梯度。而每个词表里都有从不出现的 token:像 <reserved_12> 这样的保留占位符,还有为了把词表凑成整齐大小而补上的填充行。权重衰减可能把这些行按某个常数比例缩小,但图案还在。
这些行很好找。一行新生成的高斯噪声,长度是可以预测的:σ × √(行宽),对 DeepSeek-V4-Flash 来说就是 0.006 × √4096 = 0.384。训练过的行要长得多,而且每个 token 各不相同;未经训练的行则在预测值上排成一条平线。
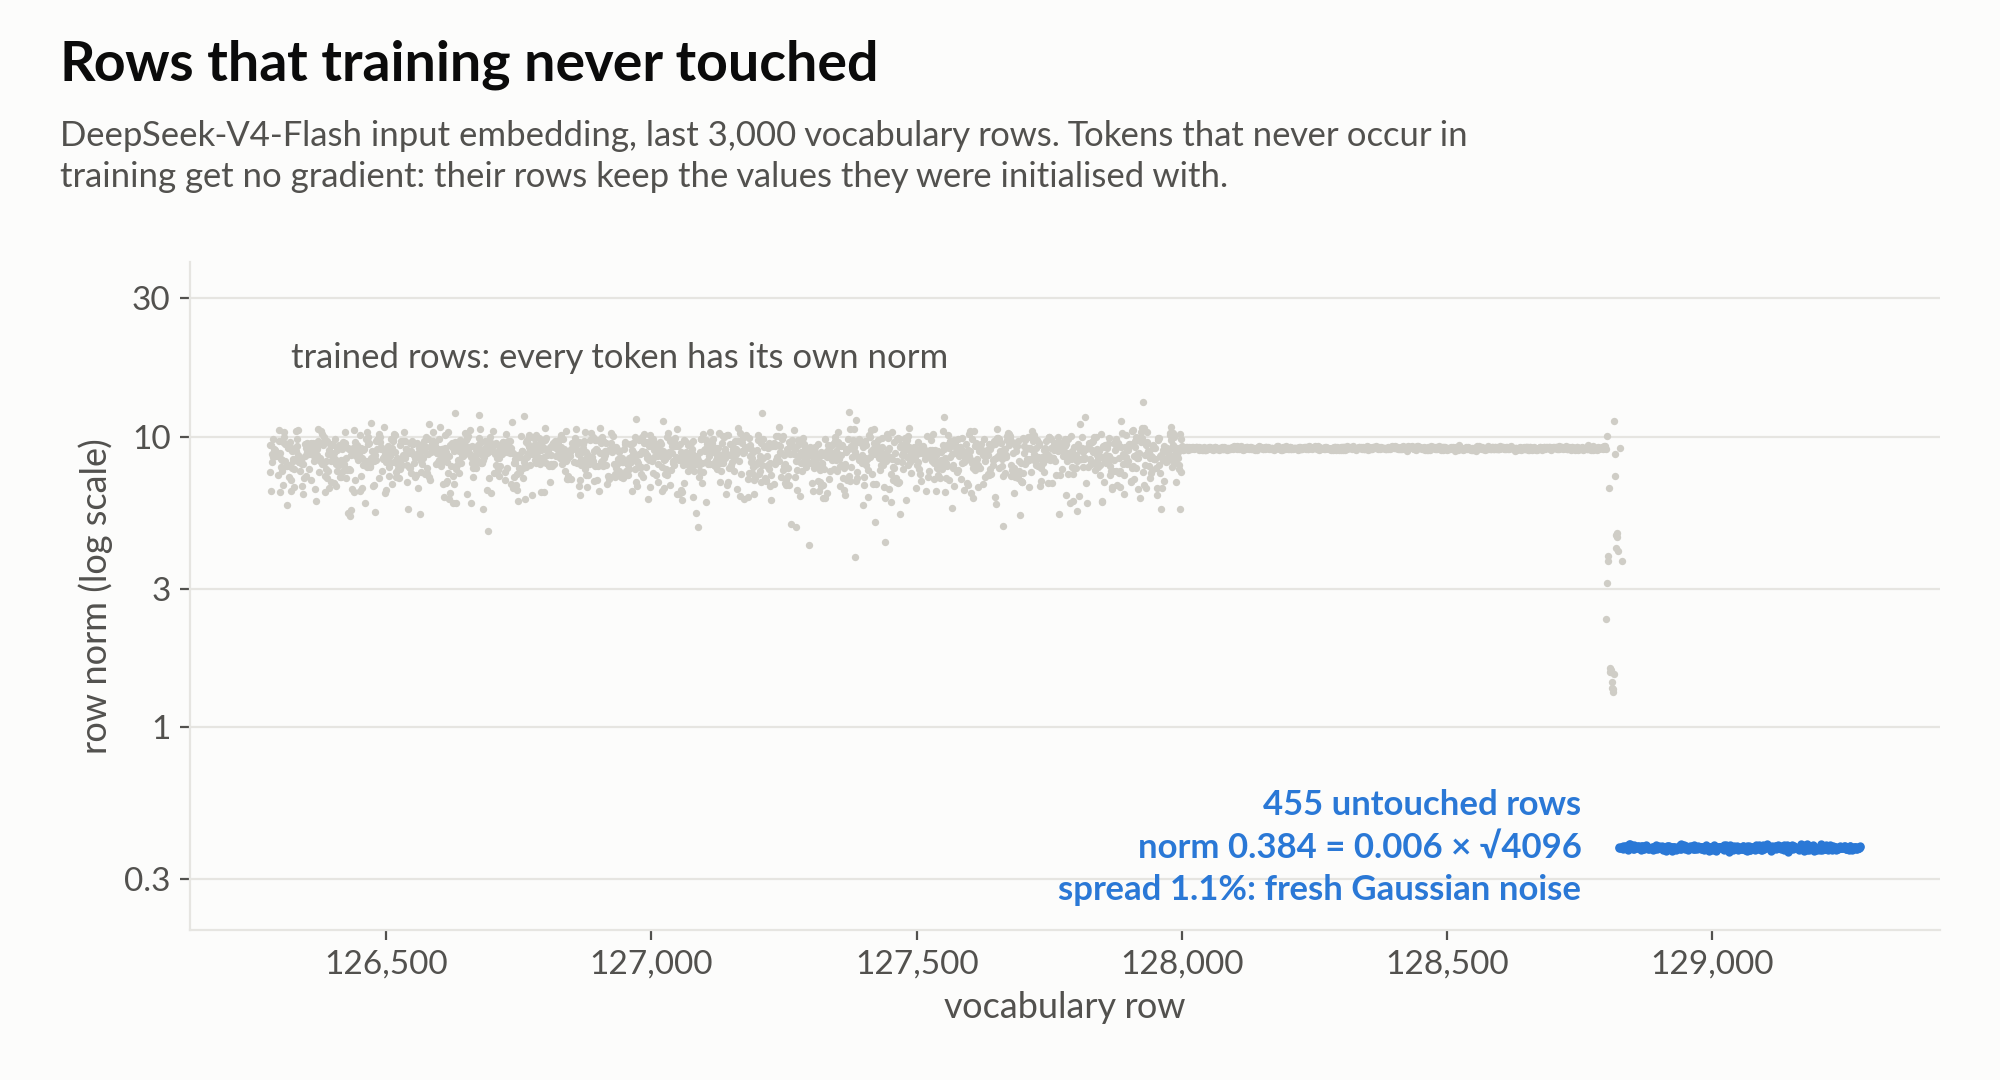 DeepSeek-V4-Flash 词表末尾的行范数
重新生成,然后比对
未经训练的行完全由种子和 T 决定,所以我在每个候选的 T 下把它们重新生成一遍,再和公开的权重比对。以种子为 953049583 的 DeepSeek-V4-Flash 为例:B200/B300 的线程数能复现这些行,Hopper 的线程数给出的则是毫不相干的噪声。
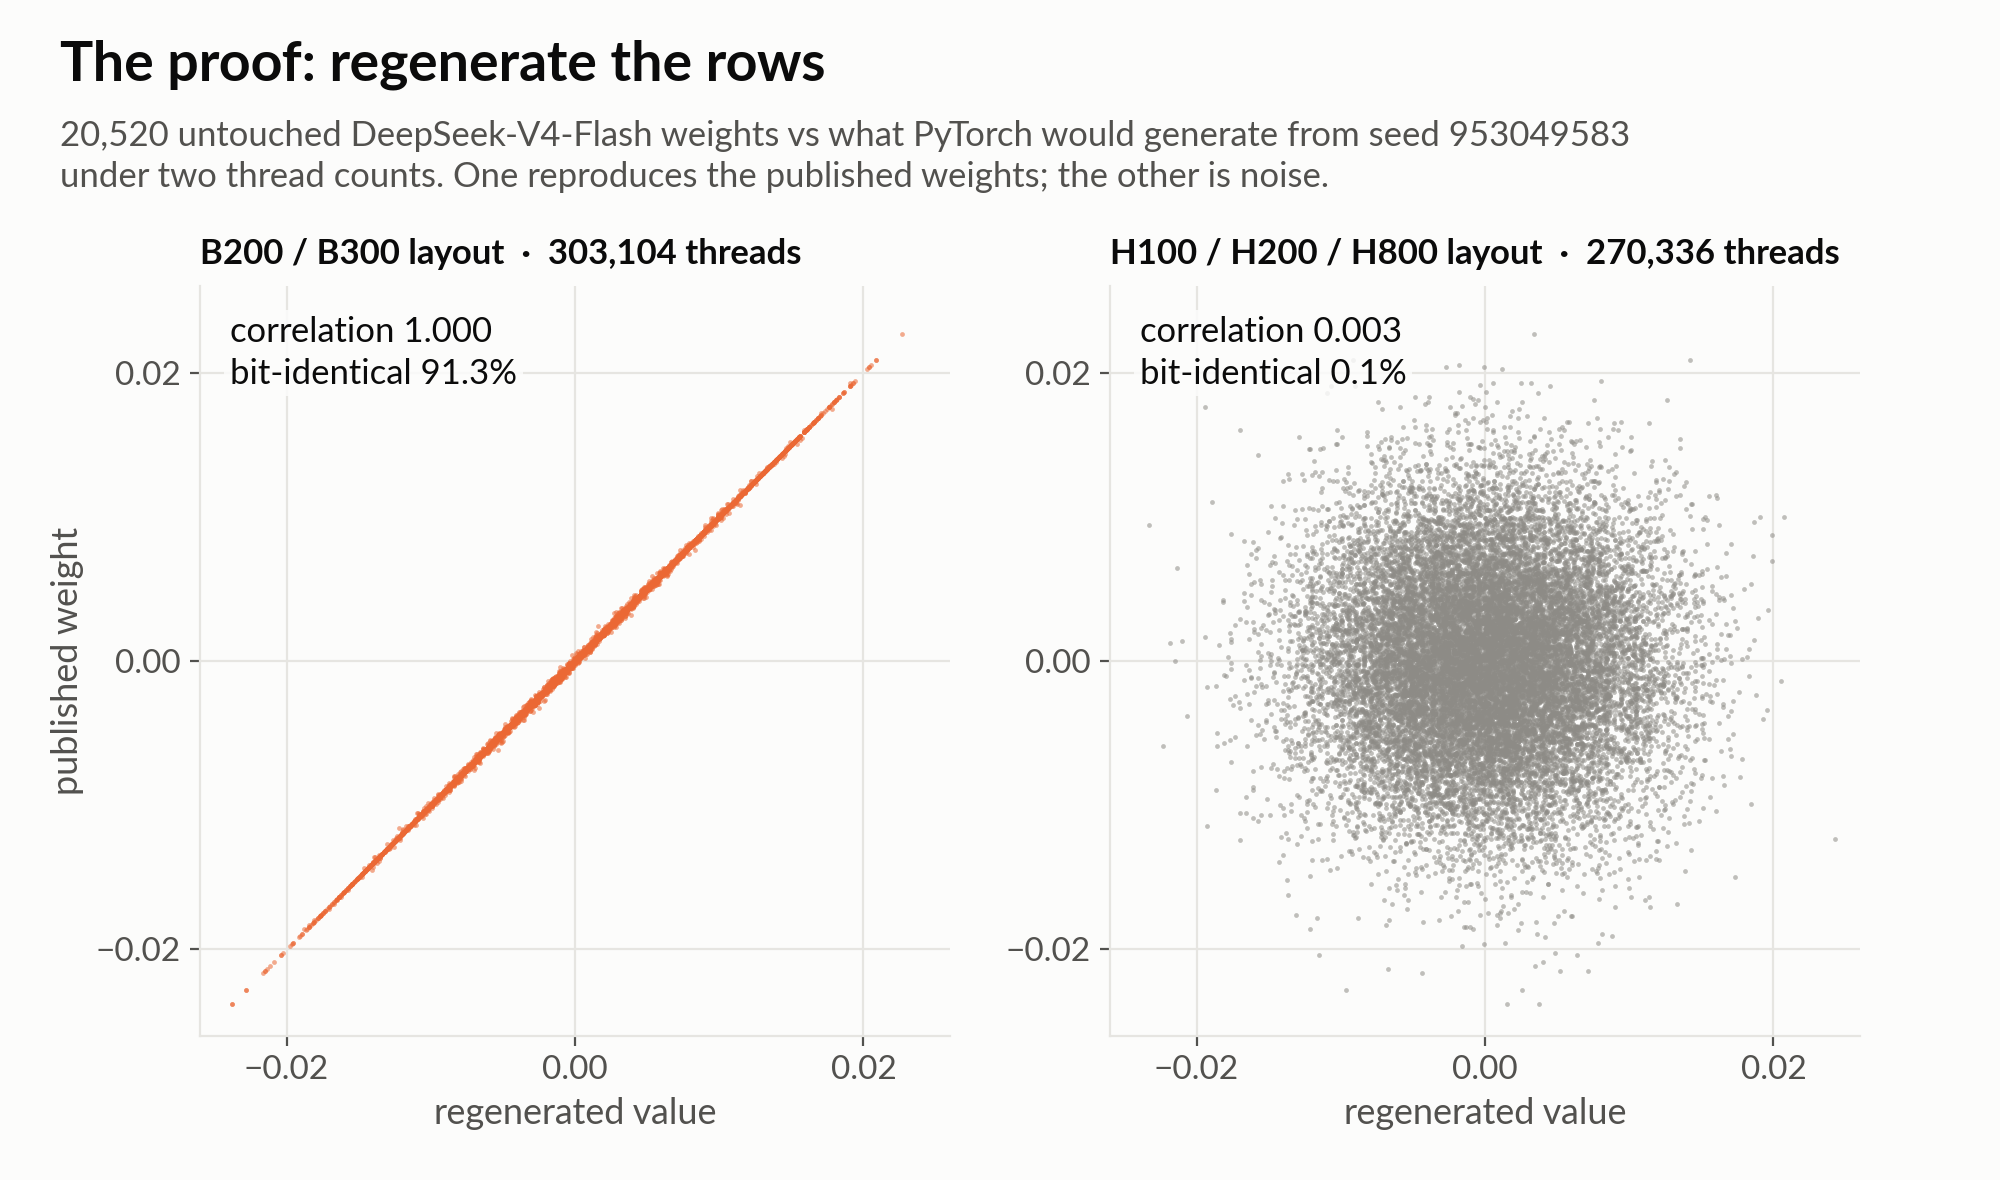 公开的权重与两种线程数下重新生成的值的对比
我测了 19 种线程数,从 T4 到 AMD 的 MI300X,只有一种吻合:468 个候选行里有 461 行匹配;把这 468 行、190 万个数全算进去,得分比随机水平高出 1,300 多个标准差。对于那些来自未经训练的行的 Blackwell 级读数,我还做了一次更宽的扫描,覆盖 822 种线程数;除了「局限」一节讲的 AMD 情况,没有找到第二个吻合的。
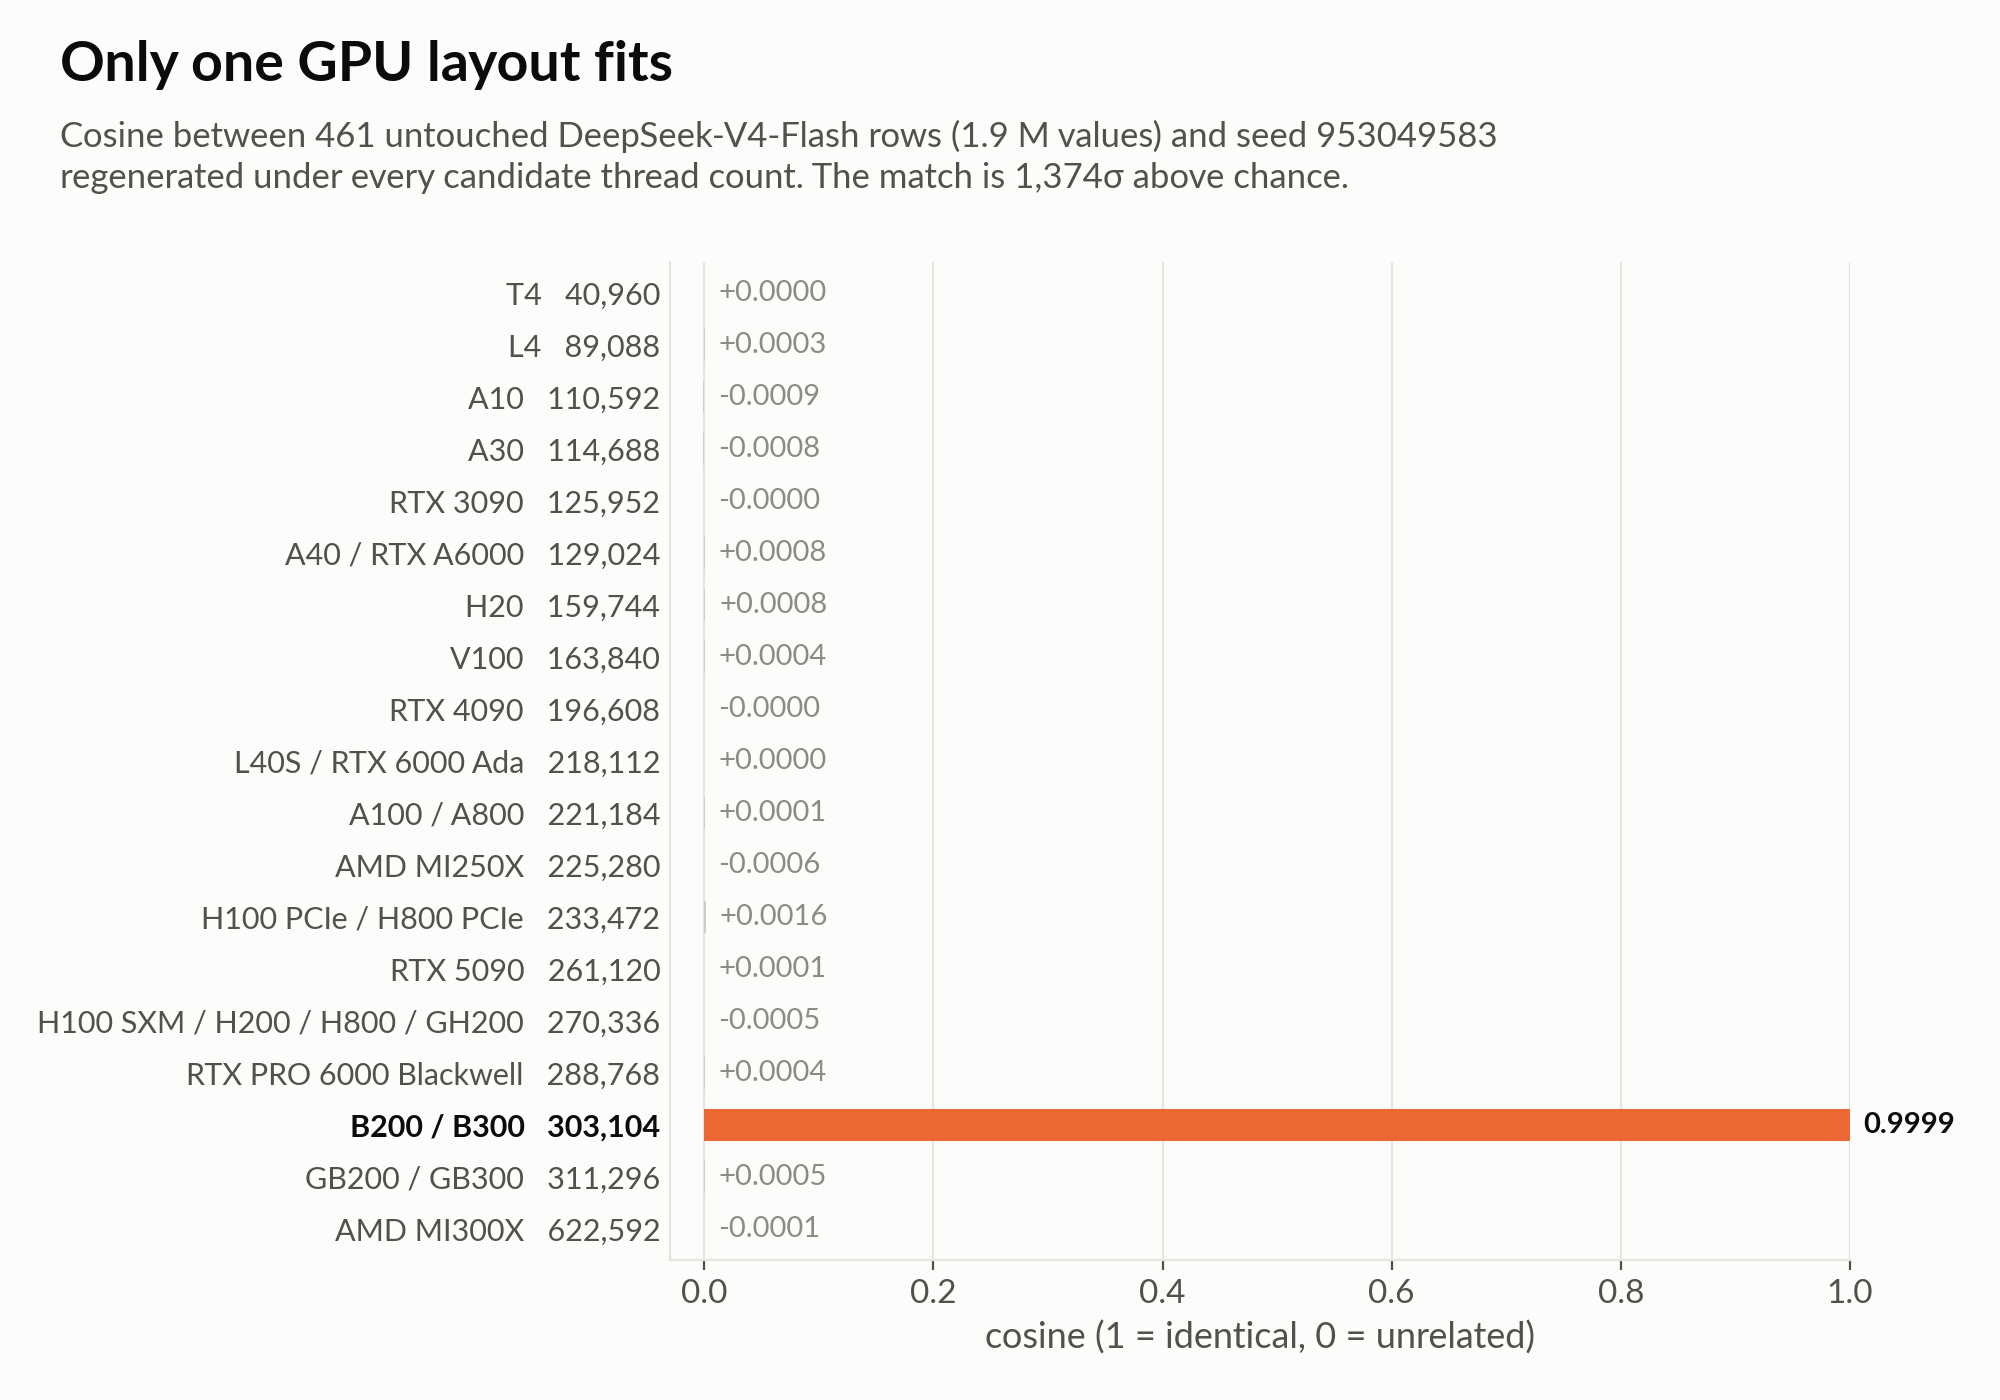 每个候选线程数的匹配得分
种子靠暴力搜索。人手动输入的种子几乎都小于 2³²,也就是大约 43 亿个;借助 Philox,一块 GPU 大约一分钟就能全部试完。给出 DeepSeek-V4-Flash 一行未经训练的行里的 64 个数,搜索只返回一个结果:953049583,正是原文报告的那个种子。T 不对的话,一个种子都找不到。
别的填充方式,别的排布
第一轮扫描下来,大约有一百个模型有干净的未经训练的行,却找不到种子。其中很多是同一个原因:Mistral、Meta、AI2、蚂蚁、Upstage 等用 PyTorch 的 trunc_normal_ 做初始化,它不会产生超出调用方所设截断值的数,在这些模型里截断值大约是 3σ。它先抽均匀分布的数(在 GPU 上,这些数落在同样的条纹里),再用 erfinv 把它们弯成钟形。而我的搜索找的是普通的正态填充。
这些行会自己露馅:分布比高斯略平一点(超额峰度是 −0.17 而不是 0),而且没有一个值超过 3σ。办法是用 erf 把每个值弯回去,还原出均匀分布的数,再拿这些数去搜。
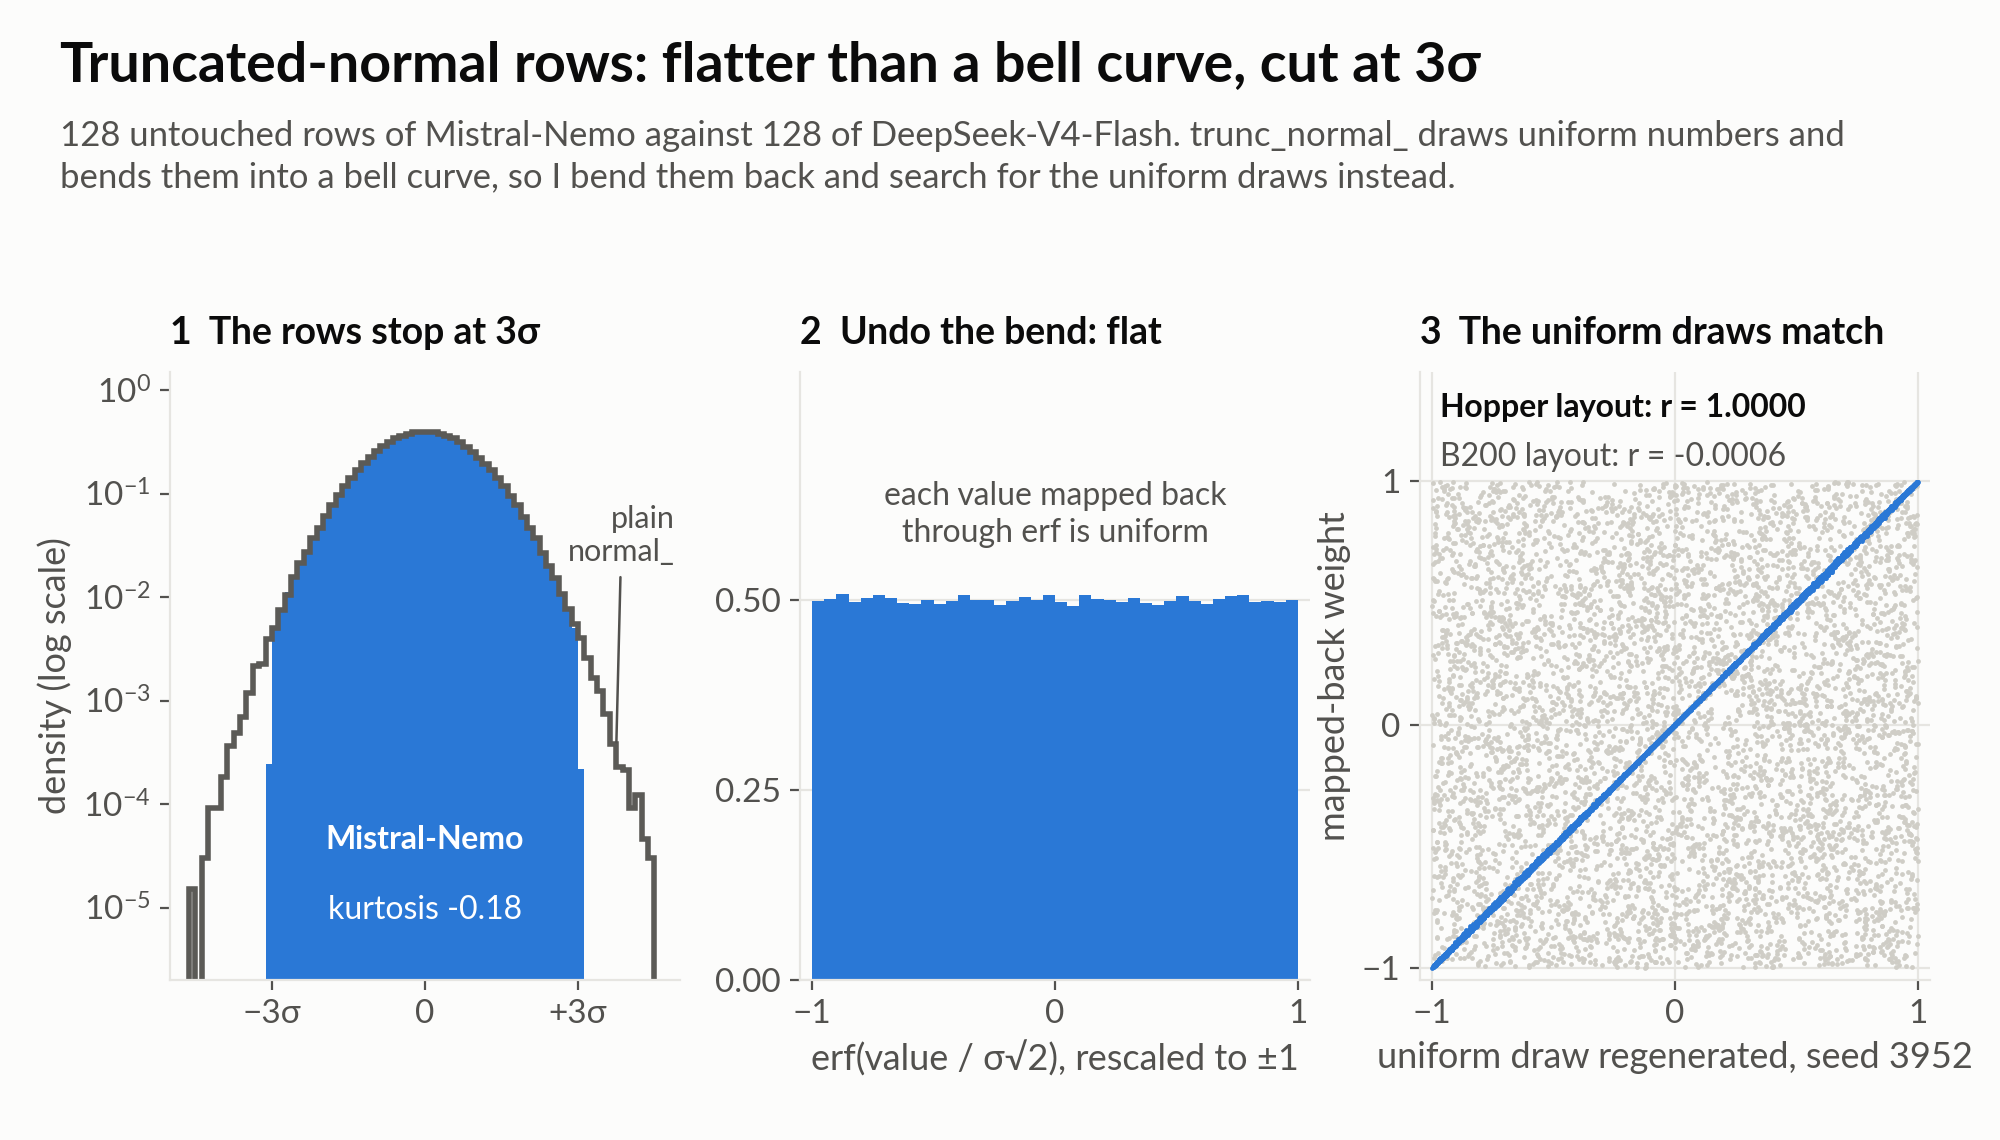 截断正态初始化的未经训练的行,映射回均匀分布的抽样
只改了这一处,就读出了 Mistral、Llama-3、OLMo、Ling、LLaDA、Solar、Jais 和 Gravity。阶跃星辰的行更简单,就是普通的均匀填充。
另外,大模型也很少作为一整个张量、在单块 GPU 上初始化,而每个框架切分的方式又各不相同。
- 每块 GPU 一个种子。 Megatron 给每块 GPU 分一段词表,种子取 seed + 2718 + rank。Llama-3 就是这么填的,种子依次是 2718、2719……;XVERSE、OPT、Stockmark 和 Qwen2 的尾部也是这样。MiniMax-M2 分成四份,用的是自己的规则:1001102 + 1021 × rank。Mistral 较新的模型则给每一块行或列分别以 0、1、2……为种子。
- 每个 pipeline stage 一个种子。 Megatron 每过一个 stage 加 100,所以 Qwen3.5-397B 输出层的种子是 4252,而 embedding 是 3952。
- 同一个种子,不同的流位置。 PyTorch 的分布式张量给每块 GPU 相同的种子、不同的起点。Inkling 就是这样切成 64 到 256 个列块的,OLMo-2 和 Granite 则切成行块。单纯的偏移也是同一个道理:先初始化的张量已经把生成器往前推了一段,所以 Kimi K3 位于月之暗面那个种子的偏移 3,776 处,Qwen3.5-397B 的 embedding 位于偏移 828 处。
PaddlePaddle 普通的 GPU 填充,写出来的也是同样的条纹,这一点我在自己的卡上用真实的 Paddle 验证过。
CPU 写的行
有些未经训练的行对不上任何 GPU 线程数,因为它们是 CPU 写的。PyTorch 的 CPU 生成器只有一条 Mersenne Twister(mt19937)流,数是一个接一个吐出来的,没有线程排布,也透露不了任何硬件信息。但即使不知道种子,也能证明是它。在 bf16 张量上,CPU 填充只用到生成器每个输出的低 8 位,而且是成对写入数值的(Box–Muller 变换),每一对的角度就能把这些位还原出来。几行数据就能凑出大约 30,000 个 GF(2) 上的方程,未知数是生成器的 19,937 个状态位。方程之间零矛盾,就证明这是一条 CPU 流;解出来的状态还能一路倒推回种子。
Jamba 是 CPU 上的 torch.manual_seed(23),能复现 1,019 个未经训练的行;AliceAI 是种子 1234。InternLM2-1.8B 是种子 1001,而 InternLM 公开的训练代码 InternEvo 确实把 embedding 分配在 CPU 上。出乎意料的是 Qwen:很多模型里那些「未经训练」的行,其实是训练之后才覆盖到没用到的行上的 CPU 噪声。Qwen3-8B、14B、30B、32B 和 4 月版的 Qwen3-235B 各用各的种子,其中 8B、14B 和 30B 的行可以逐比特复现。Qwen3.5-9B 和 27B、Qwen3.8-27B 和 2.4T 都用种子 42。Qwen3.8-2.4T 依据训练过的行和输出层,仍然能读出 Hopper。Qwen3.5-35B、122B 和 397B 的未经训练的行,则不是 CPU 流。所以,原文里「Qwen3 在 CPU 上初始化」这个读数,描述的其实是被覆盖过的行。而在留有早先副本的 Qwen3-235B 2507 版里,真正的初始化读出来是 Hopper。
训练过的行也留有痕迹
有些模型没有未经训练的行。但训练只是把一行轻轻推一推,并没有把它换掉,所以一个起点偏高的权重,通常还是留在偏高的一侧。
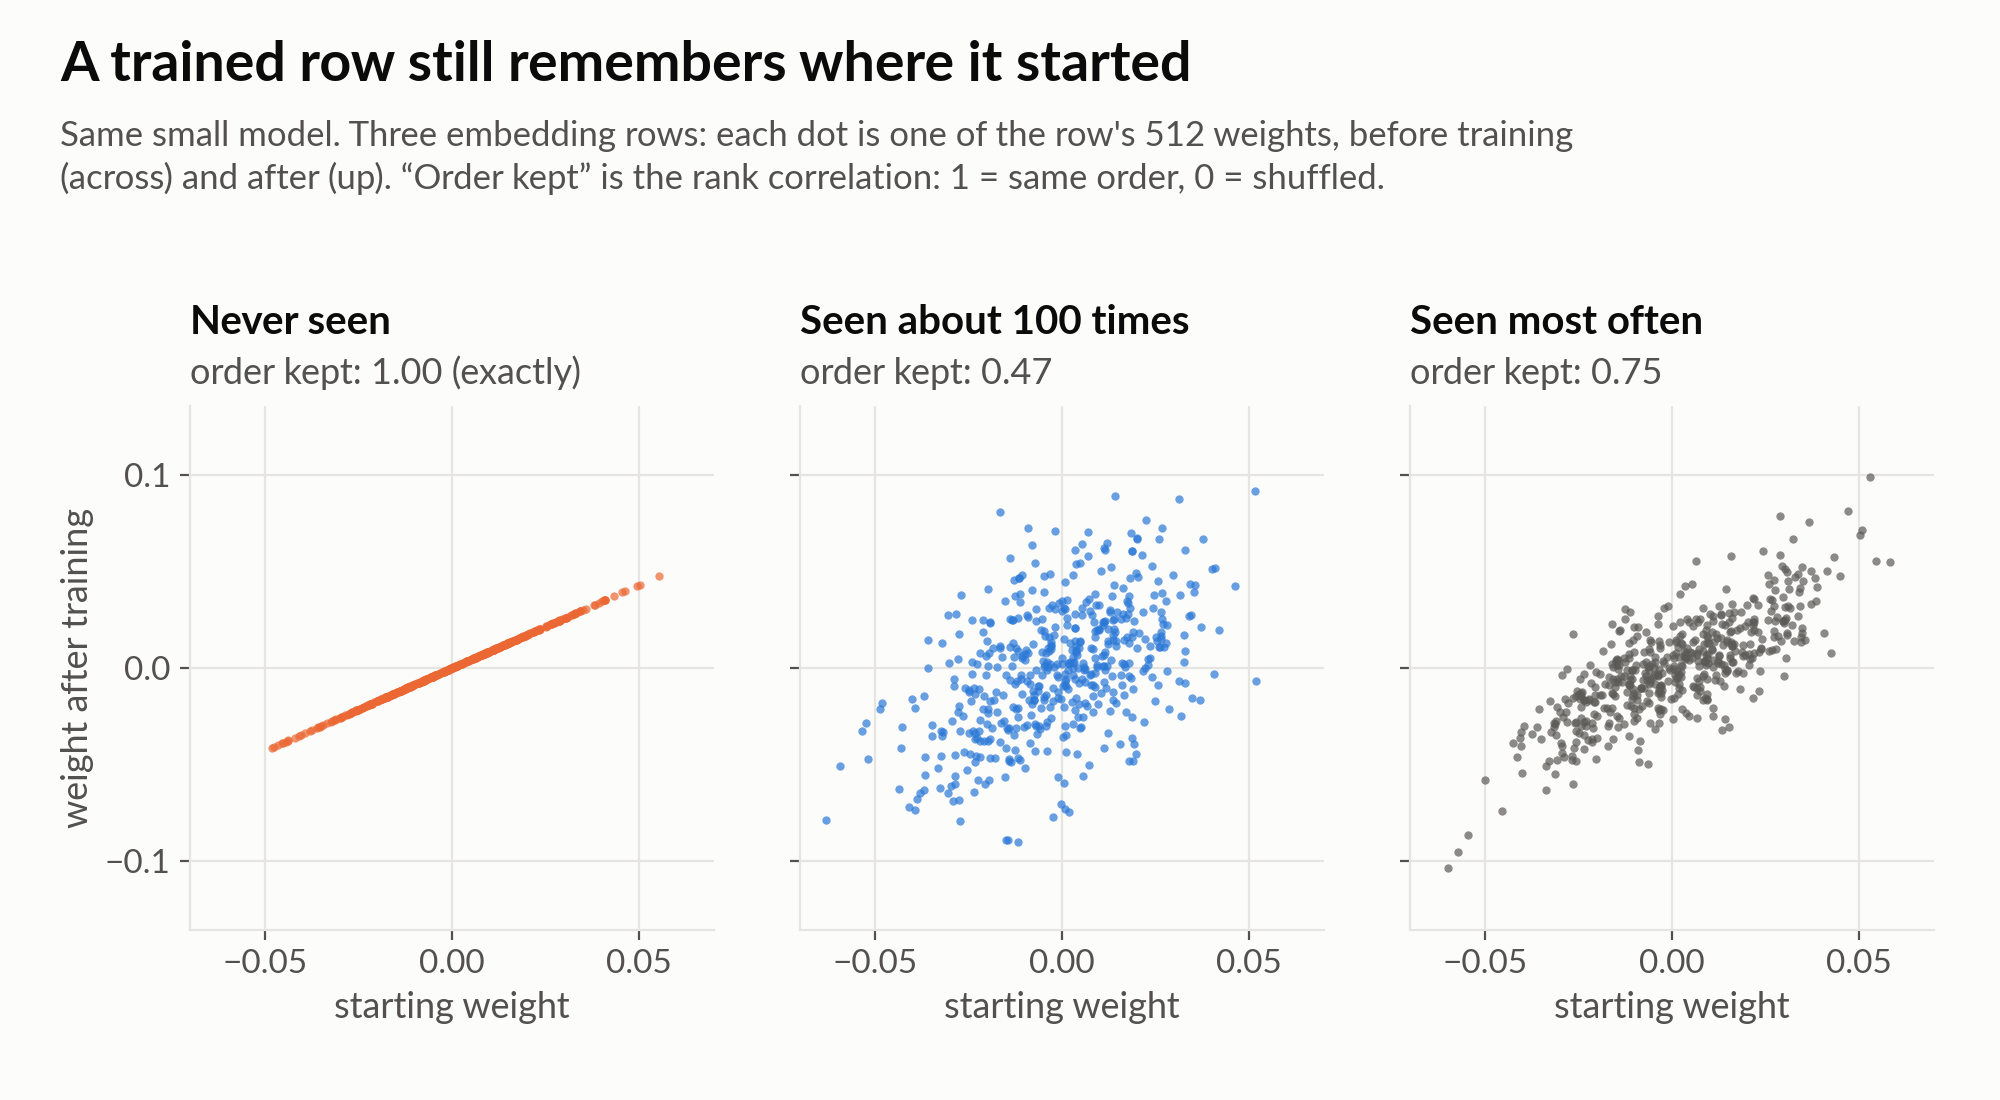 一个小模型训练前后的权重
在大模型里,单看一行,这个痕迹很弱。以小米的 MiMo-V2.5-Pro-Base 为例(种子我已经从它未经训练的行里知道了),训练过的行和重新生成的初始值之间,余弦相似度的中位数只有 0.034。但在 16,384 行上累加起来,Hopper 的线程数达到 488 个标准差,其他任何线程数最多只有 5。那 28 个带剑号的模型就是这样读出来的,包括 Nemotron-3 Ultra、Granite-Switch、Qwen3.8-Flash-Next、Llama-4 和 ZAYA1。只有当读数在另一组不重叠的行上同样成立、而且没有别的线程数接近时,我才算它数。
这一档证据比未经训练的行弱:我没法重新生成公开的数值,只能说明它们和某一个候选相关、和其他候选都不相关。它还得先有一个种子可测,通常来自同系列的兄弟模型,或者别的实验室用过的种子。
只剩符号的行(‡)。 在 Qwen2-7B、Qwen2.5-7B 和 Qwen2-57B 里,权重衰减已经把没用到的行缩到了存储格式能表示的最小的数,大约 10⁻³⁷。每个值的大小都一样,只剩下符号,但符号还是当初的符号。词表分成四份,在 Hopper 的线程数下,符号与种子 6125 + rank 在 99% 以上的位置吻合,在其他任何线程数下只有大约 50%,也就是随机水平。第四个这样的读数是 NVIDIA 的 Nemotron-Nano-9B-v2:它的 embedding 是 Nemotron-Nano-12B-v2 的 embedding 按列裁剪出来的副本,而后者衰减过的行,在 Hopper 上与种子 3952 的符号 100% 一致。
Kimi-K2.7-Code:一行里有两种 GPU
原文对 Kimi-K2.7-Code 的描述是:大约 80% 是从 K2.5 继承来的 Hopper 值,大约 20% 是一次 B200 级的抽样。我第一轮扫描只看到了 Hopper。
它词表里最新的 254 行,是作为一个单独的小张量初始化的,种子是 244。在 Hopper 的线程数下,这些行得分 0.97,而未经训练的行应该得 1。从每一行 K2.7 里减去 0.8 × 对应的 K2.5 行,剩下的部分在 B200/B300 的线程数下与同一个种子吻合,得分 0.9998。
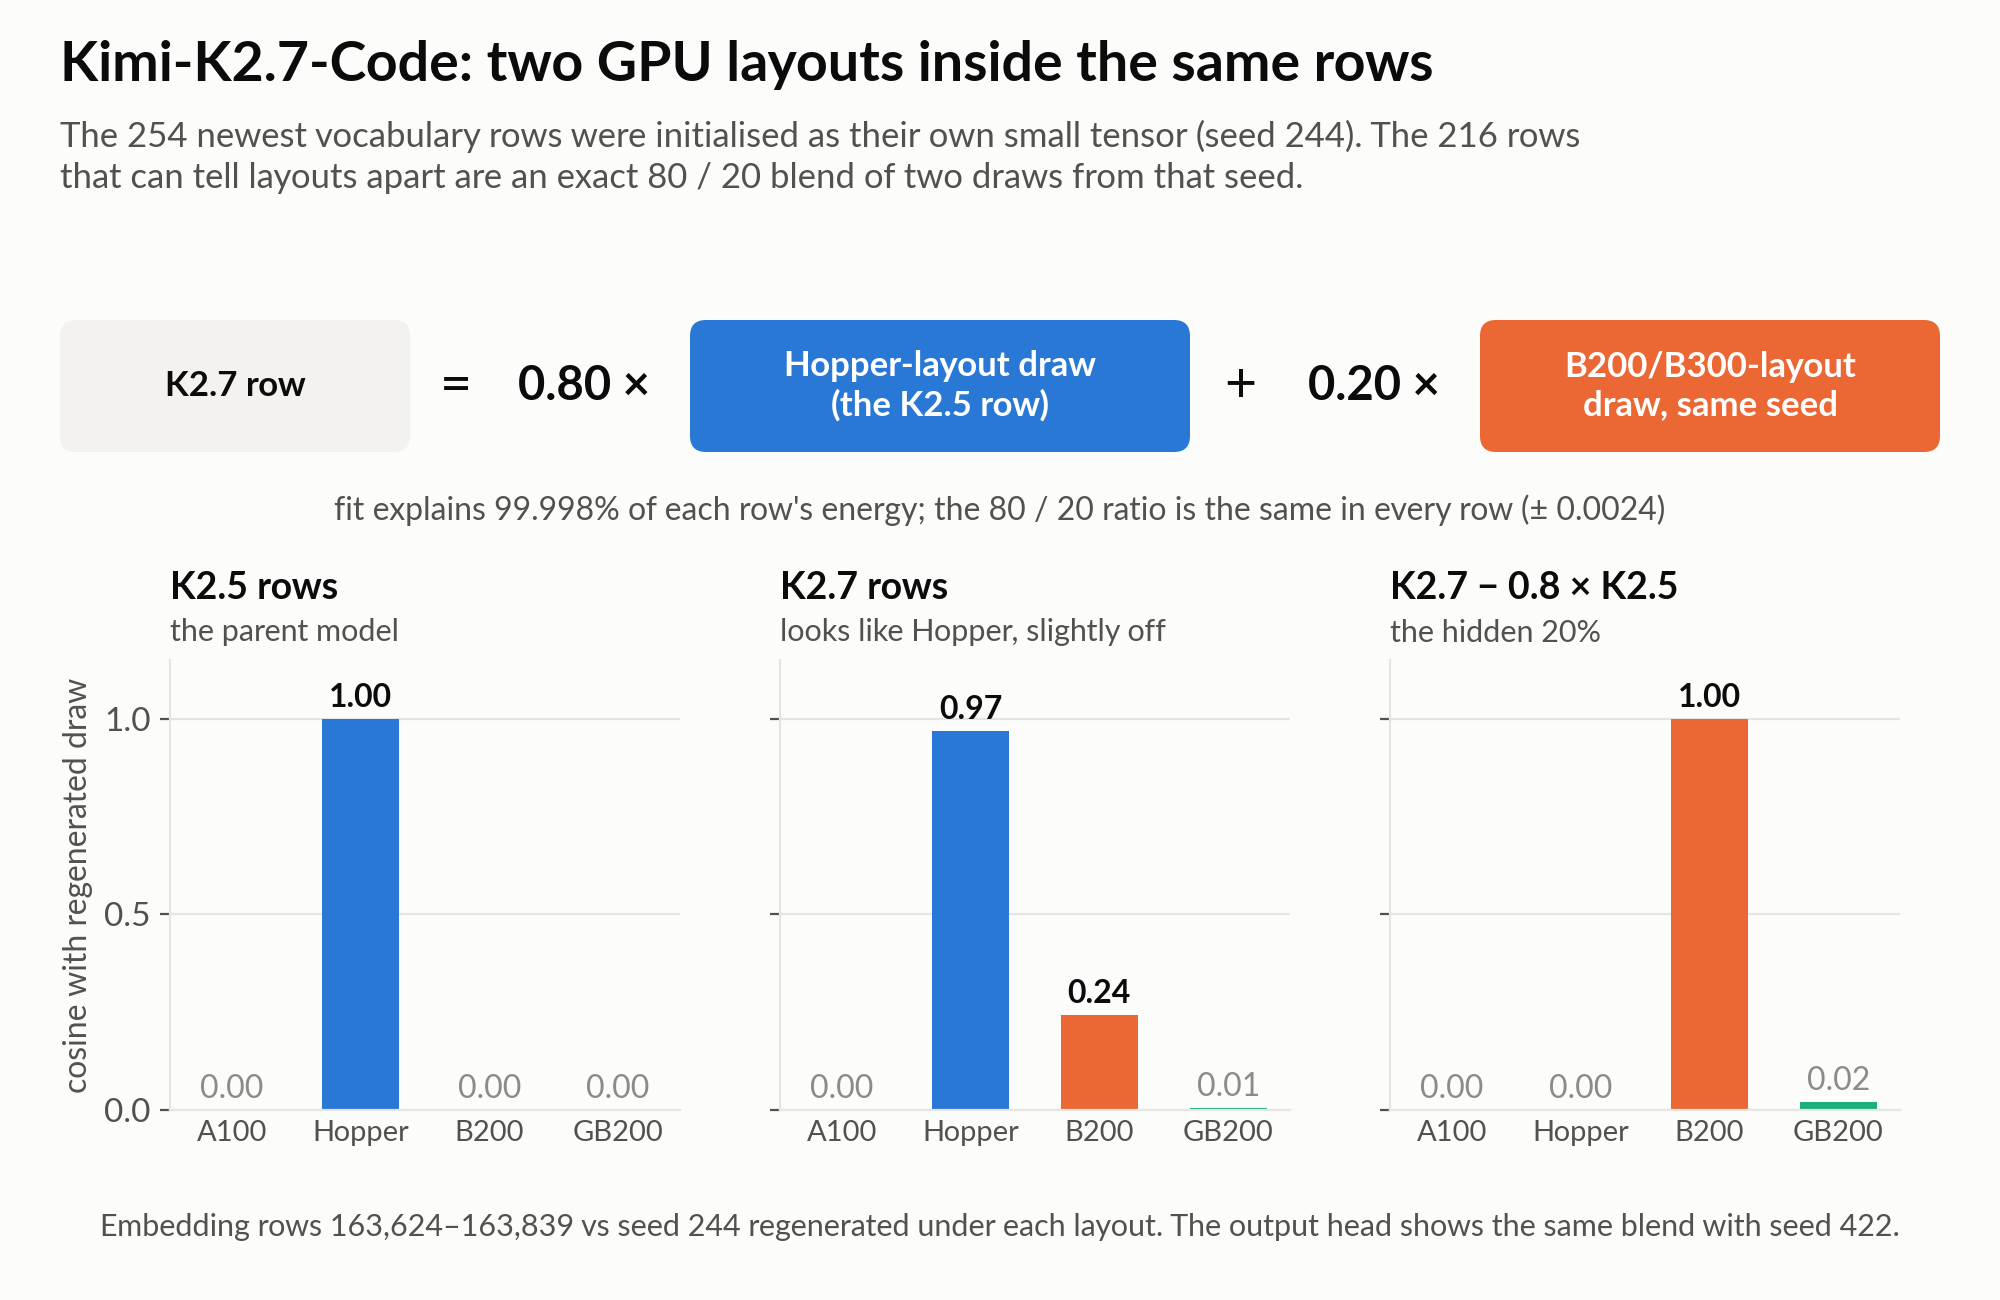 Kimi-K2.7-Code 的新增行是两种线程数的混合
这个比例几乎每一行都一样,误差不到百分之一,看起来像是两个 checkpoint 的加权平均,和原文的猜测一致。在最前面 37 行里,也就是两种 GPU 写出相同数值的第一条条纹之内,这种混合是看不出来的。它能说明的只是:有一台 303,104 个线程的设备,把这次小小的初始化又跑了一遍。K2.7 我单独统计,不计入 Hopper 和 B200 的总数。
用已知答案检验
公开披露的硬件。 最好的检验,是拿开发者自己说过用什么硬件训练的模型来对答案。这样的模型我有 25 个,分布在六种线程数上,读数每一次都对得上。
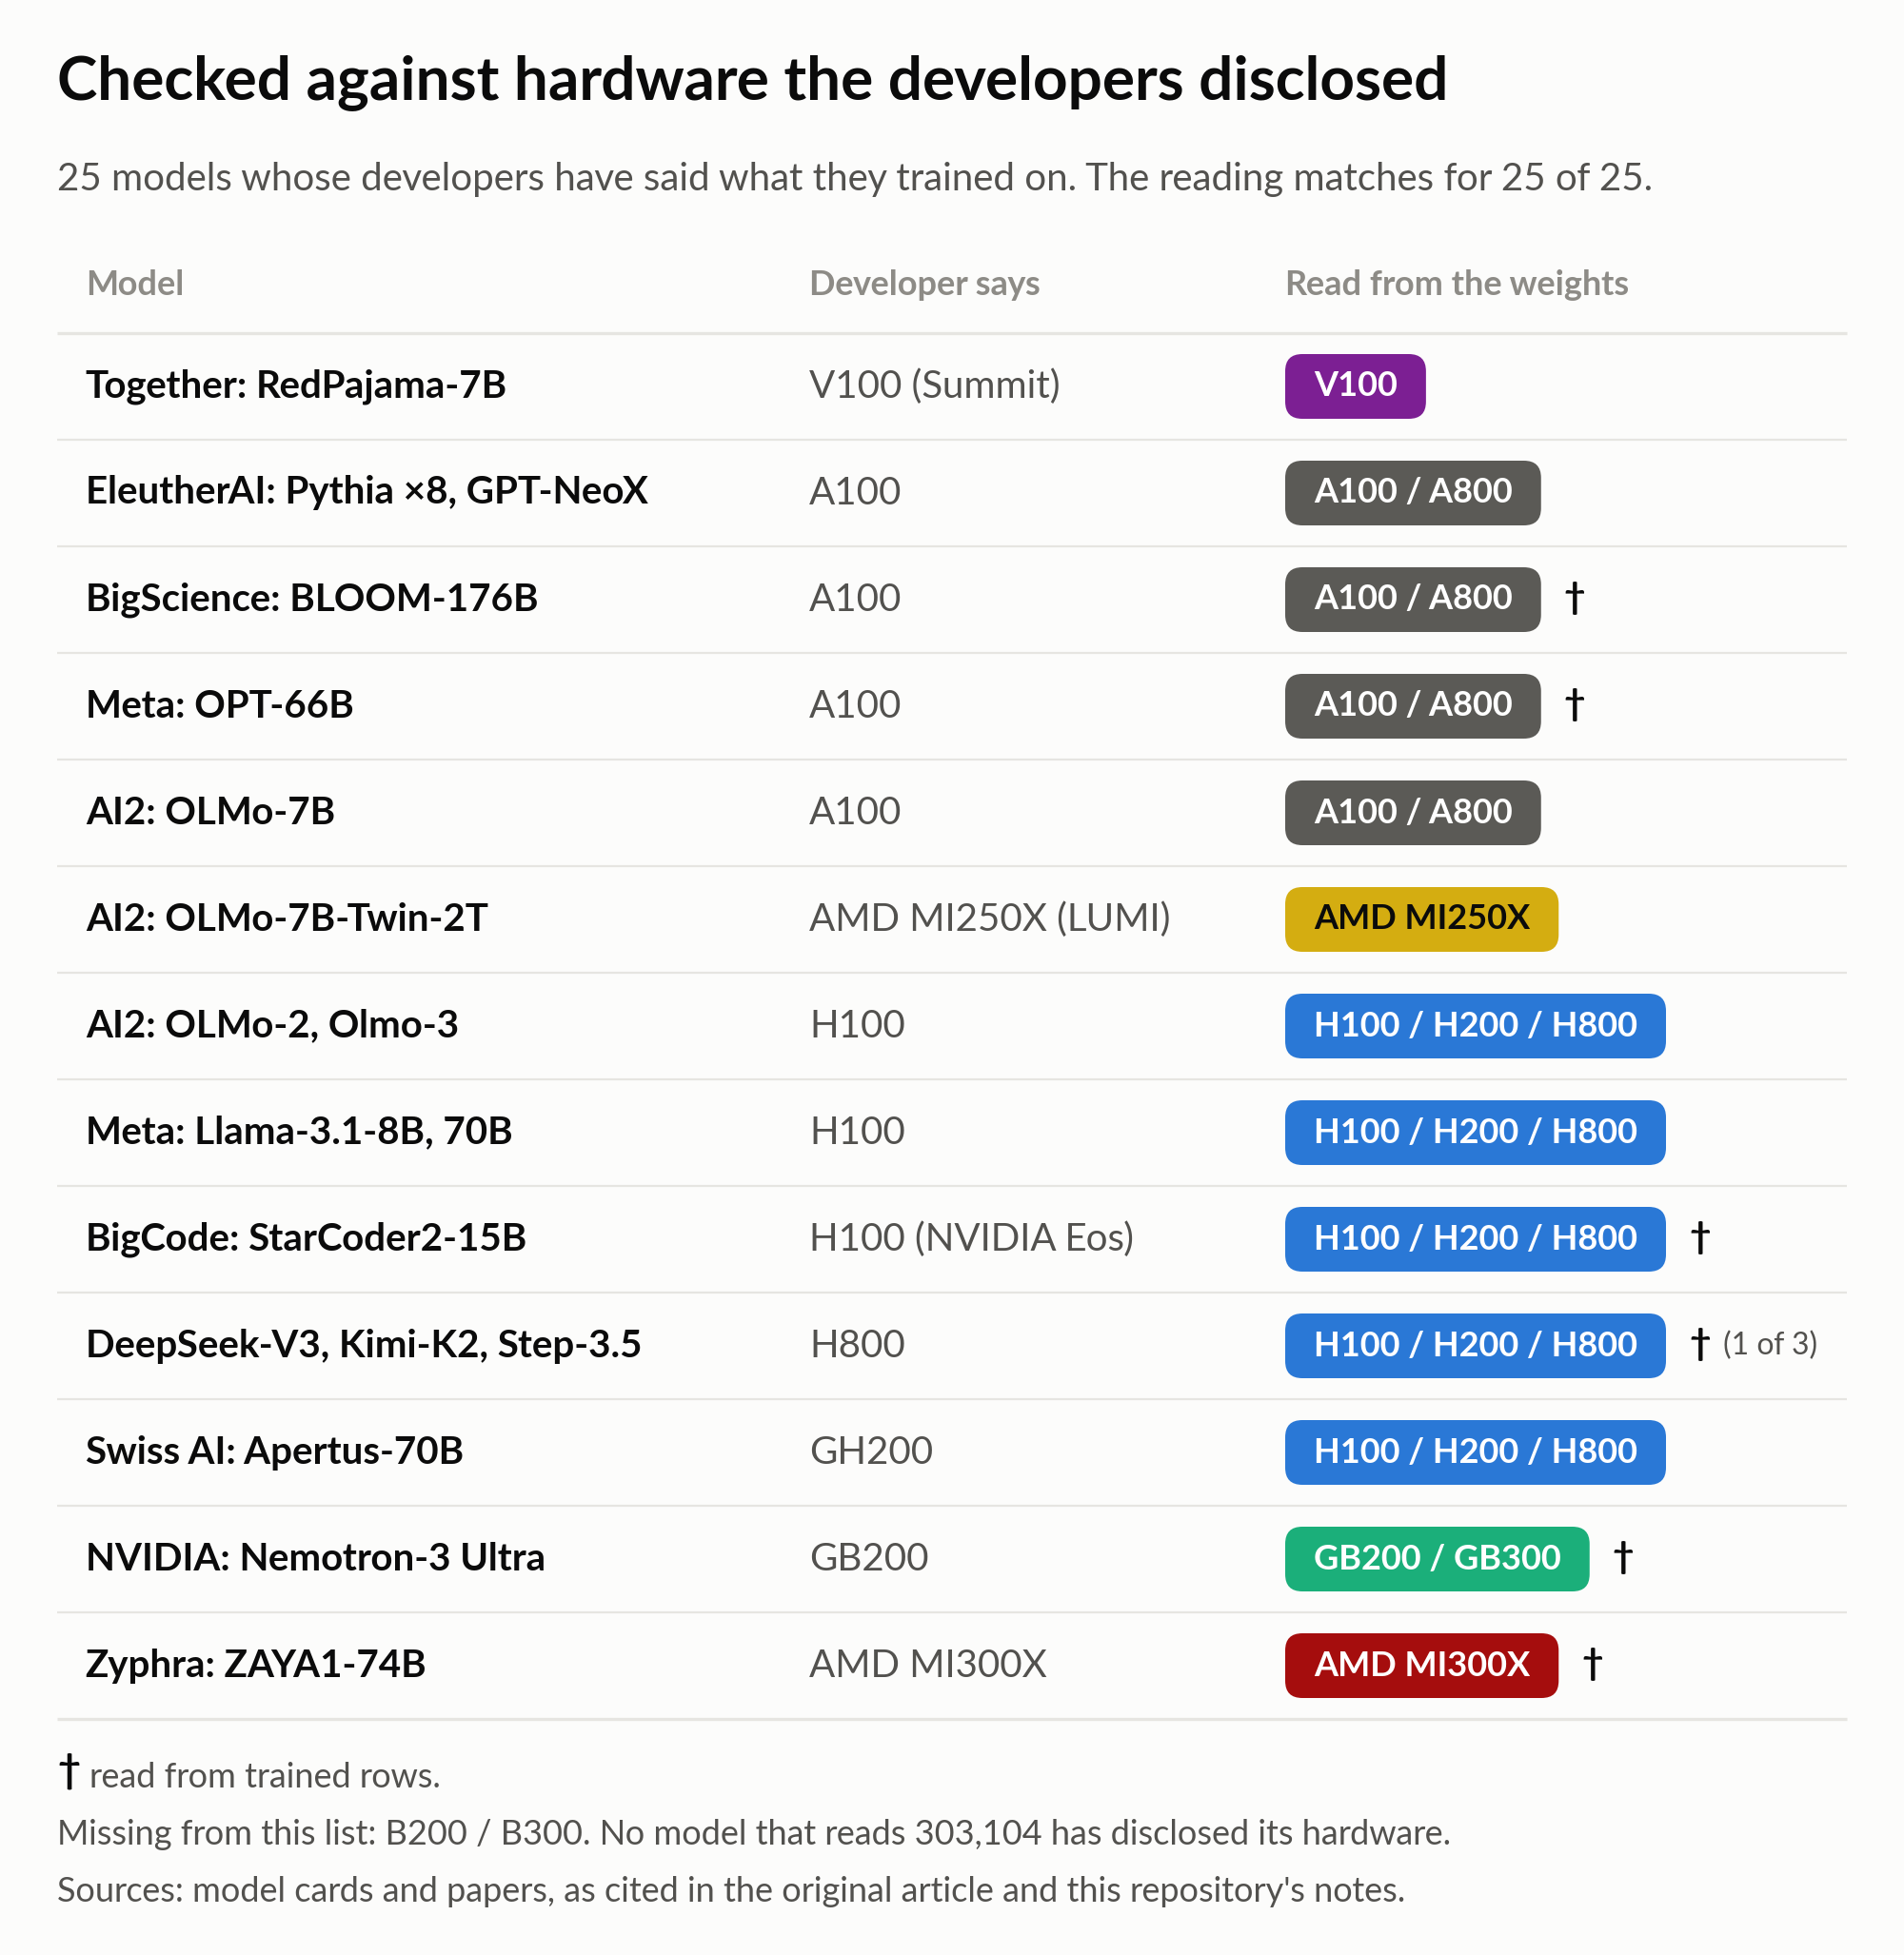 公开披露的硬件与从权重读出的类别对照
AI2 是最有用的一例:OLMo 先后换过三种硬件,而且每次都公开说了——OLMo-7B 用 A100,OLMo-7B-Twin-2T 用 LUMI 上的 AMD MI250X,之后用 H100。读数也跟着变。我还复现了 Llama-3.1,也就是原文拿来做已知答案检验的那个例子。
唯独缺了一个类别:读出 303,104 的模型里,没有一个披露过自己的硬件。B200/B300 这个标签和 GB200/GB300 一样,依据的是原文——原文作者在一块实体的 B300 和一台租来的 GB200 上实际跑过这个填充。
我自己的模型。 我在自己的 RTX PRO 6000 上训练了一个小模型,它最后 256 个 token 在训练文本里从不出现。训练之后,这些行的方向和训练前完全一样(余弦 1.0000;由于权重衰减,幅度缩到了 0.86 倍)。只给训练后的 checkpoint,搜索就找回了正确的种子和 288,768 个线程;只用训练过的行,也能得到同样的答案。
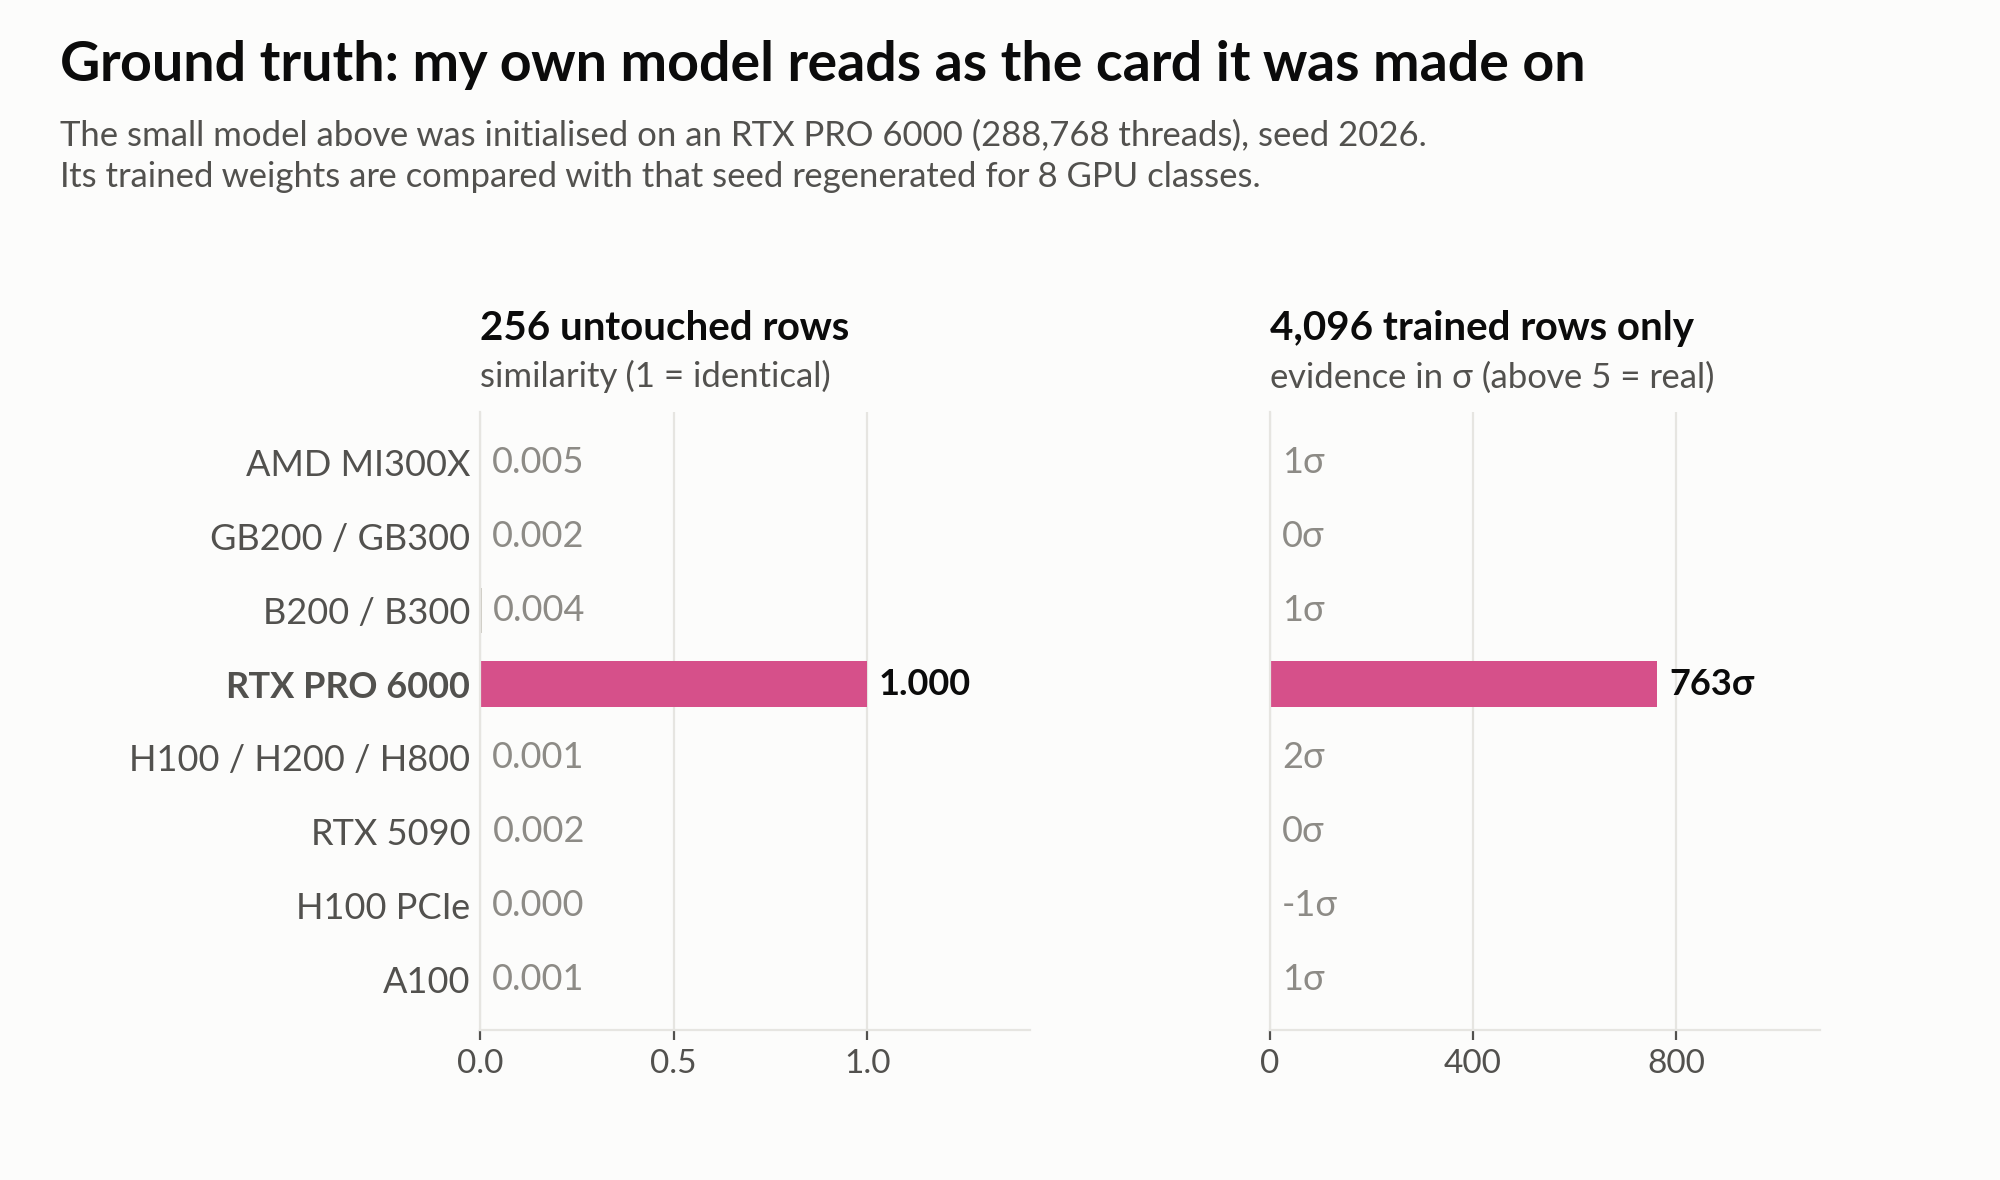 恢复一个本地训练的模型的种子和线程数
Pythia。 EleutherAI 公开记录了 Pythia 用的是 A100,还发布了训练开始之前的 checkpoint。对 Pythia-70M,工具在 A100 的线程数下找到了种子 3952,并逐比特重新生成了全部 25,755,648 个初始 embedding 值(这是一次 fp16 填充),其他线程数都做不到。事先不知道答案、只看最终 checkpoint 里未经训练的行做盲测,也能得到同样的结果。
局限
- 线程数不等于芯片。 它分不出 H100、H200 和 H800,分不出 B200 和 B300,也分不出 GB200 和 GB300。
- AMD 可以给出 NVIDIA 的数字。 一块 MI300X 有 304 个计算单元(CU)。分成两半、每半 152 个时,每一半呈现出来的正好是 311,296 个线程,也就是 GB200/GB300 的线程数;限制到 148 个时,呈现的是 303,104,也就是 B200/B300 的线程数。原文在真实硬件上确认过这一点,而我的 AMD 读数也表明,确实有人用这类机器初始化过模型。Nemotron-3 Ultra 这个部分披露的案例,把 311,296 和 GB200 对应了起来。至于其余的 311,296 读数,以及全部十个 B200/B300 读数,换成一台这样配置的 MI300X,看起来会一模一样。
- 它可以被模仿。 软件可以模拟任意线程数,我的模拟器就是这么做的。原文还描述了另一项独立的数值检验,结果倾向于 V4-Flash 用的是 NVIDIA 硬件,这一项我没有复现。
- 初始化不等于训练。 权重可以在一台机器上创建,在另一台机器上训练。
- 它完全不涉及硬件归谁所有、放在哪里、是否合法。
- 没读出指纹,什么也说明不了。 我的搜索并不穷尽;这一轮下来也看到了,一次不完整的搜索会漏掉多少真实的指纹。
自己复现
1 | git clone https://github.com/bojieli/checkpoint-forensics |
152 个来自未经训练的行的读数中,有 138 个附带了指纹卡片,写明仓库、张量、行、种子、偏移和线程数。verify 只下载这些行,然后在每一种线程数下重新生成。随便一块 NVIDIA GPU 都行,其他线程数是模拟出来的。来自训练过的行的读数,以及需要特殊排布的读数,目前还没有卡片;它们在仓库里各有一个脚本和一份日志,需要下载几个 GB 的数据。如果你觉得哪个读数不对,卡片或脚本里有你证明这一点所需的一切,也欢迎告诉我。
方法和最初的读数来自 Unemployment Labs 的 Will DePue 所写的 Checkpoint forensics。本文是李博杰(Bojie Li)独立完成的净室(clean-room)实现与复现。代码、卡片和完整结果见 github.com/bojieli/checkpoint-forensics;逐个模型的全部读数见 READINGS.md。